目次
おはようございます。
今日は「Supermemory」をリサーチしました。細かい技術詳細よりも、AIに記憶を持たせるとはどういうことか、その存在意義と業界の変遷について解説していきます。
TL;DR
- AIが前の会話を忘れるのは一度に読める文章量に枠があるからで、Supermemory は枠の外に会話や資料を預かり、必要なぶんだけ差し戻す裏方のサービスです
- ところがこの領域は、性能を比べる物差しが壊れています。共通テストの欠陥が指摘され、2026年には Supermemory 自身が「点数は盛れる」ことをパロディで実演しました
- それでもトップページには「すべてのテストで首位」と並びます。見るべきは順位ではなく、何を覚えるか・どこにつなぐか・何に課金されるかの3つです
概要|Supermemory とは?
一言でいえば、AIに「引き継ぎメモ」を持たせるための裏方サービスです。
なぜAIは前の話を忘れるのか
ChatGPT や Claude を業務で使っていると必ずぶつかる壁があります。例えば、先週みっちり説明した自社の商流を今週の新しいチャットではまた一から説明し直すことになったり、長い議事録を貼ったのに前半の内容が消えていたりと、思い当たる場面があるはずです。
理由は単純で、いまのAIは会話のたびに、記憶がまっさらな状態から始まっているからです。過去のやりとりを踏まえているように見えるときも、実際には毎回、過去の文章をまとめて渡し直しているだけ。そして一度に渡せる文章の量には上限があります(コンテキストウィンドウ=AIが一度に目を通せる分量の枠)。会話が長くなると、この枠から古い話がこぼれ落ちる。これが「AIが忘れる」の正体です。
Supermemory がやっているのは、この枠の外に会話や資料を預かっておいて、必要になった分だけ枠の中に差し戻す仕事です。エージェント(人が都度指示しなくても作業を進めるAI)に文脈の置き場を用意する位置づけで、本体はオープンソースとして公開されています。
では、ただ預かるだけなら、これまでの仕組みと何が違うのでしょうか。
「探してくる」と「覚えている」は違う
これまで主流だったのは、資料をあらかじめ保管しておいて、質問が来たら意味の近い部分を探し出し、その場でAIに読ませるやり方です(RAG と呼ばれます)。社内の資料棚から関係のありそうな書類を数枚抜き出して、AIの机に置いてあげるイメージですね。
このやり方は「経費精算の締め日は?」のようにどこかに答えが書いてある質問には強い一方で、例えば「取引先の担当者が代わった」のような「更新」には弱いという弱点があります。棚には古い書類も新しい書類も並んでいて、どちらが今の事実なのかを棚は判断しないからです。
これに対して記憶は、書類ではなく事実そのものを持ち、後から上書きされる前提で管理します。担当者ごとのカルテを書き換えていくイメージですね。
預かるものは1種類ではない
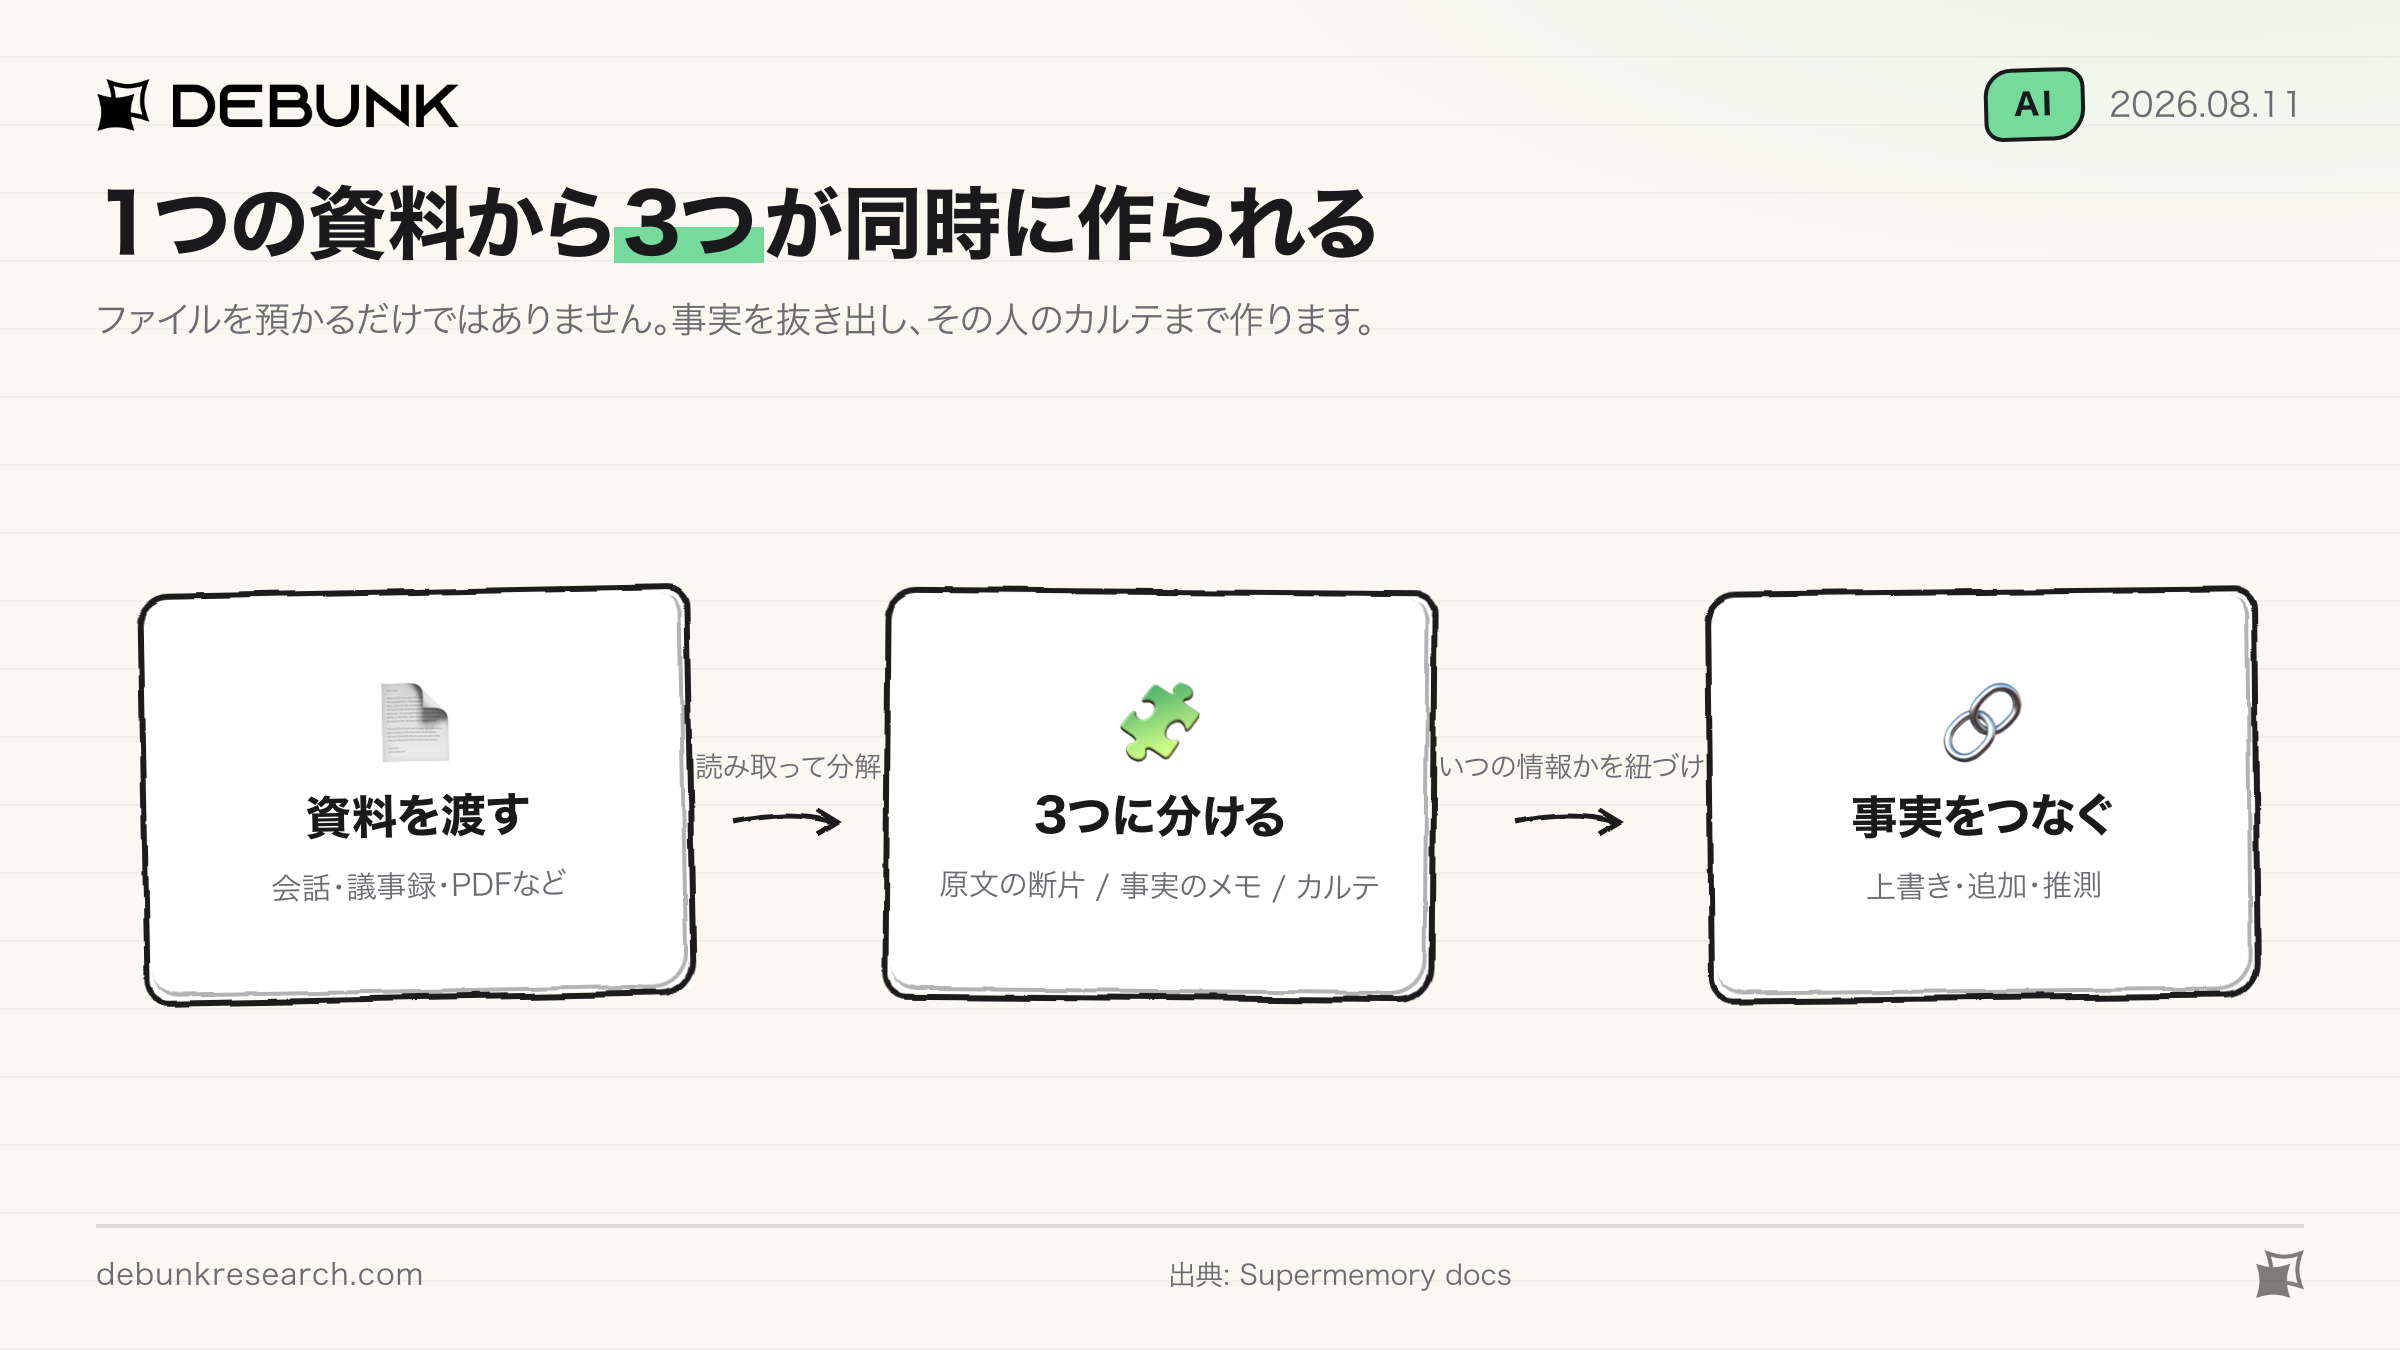
Supermemory に資料を渡すと3つのものが同時に作られます。
- 原文の断片:元の文章を切り分けたもので、「どこに書いてあったか」を示す根拠に使います
- 事実のメモ:「AさんはStripe勤務」のように抜き出した事実で、いつの情報かが紐づきます
- カルテ:その人について分かっていることの要約で、やりとりのたびに書き足されます
事実のメモは「AさんはGoogle勤務」が「Stripe勤務」に変わると、古い記述を残したまま検索には新しいほうだけを出します。加えて、誰も明言していない結論を推測して書き込む動きもあり、例えば決済APIと不正検知の話題が続いたら「Aさんはおそらく Stripe の決済担当だ」という一文を作って足す。便利ですが、後で触れる引っかかりでもあります。
どこにつなぐか|増えてきた「フォルダ」型
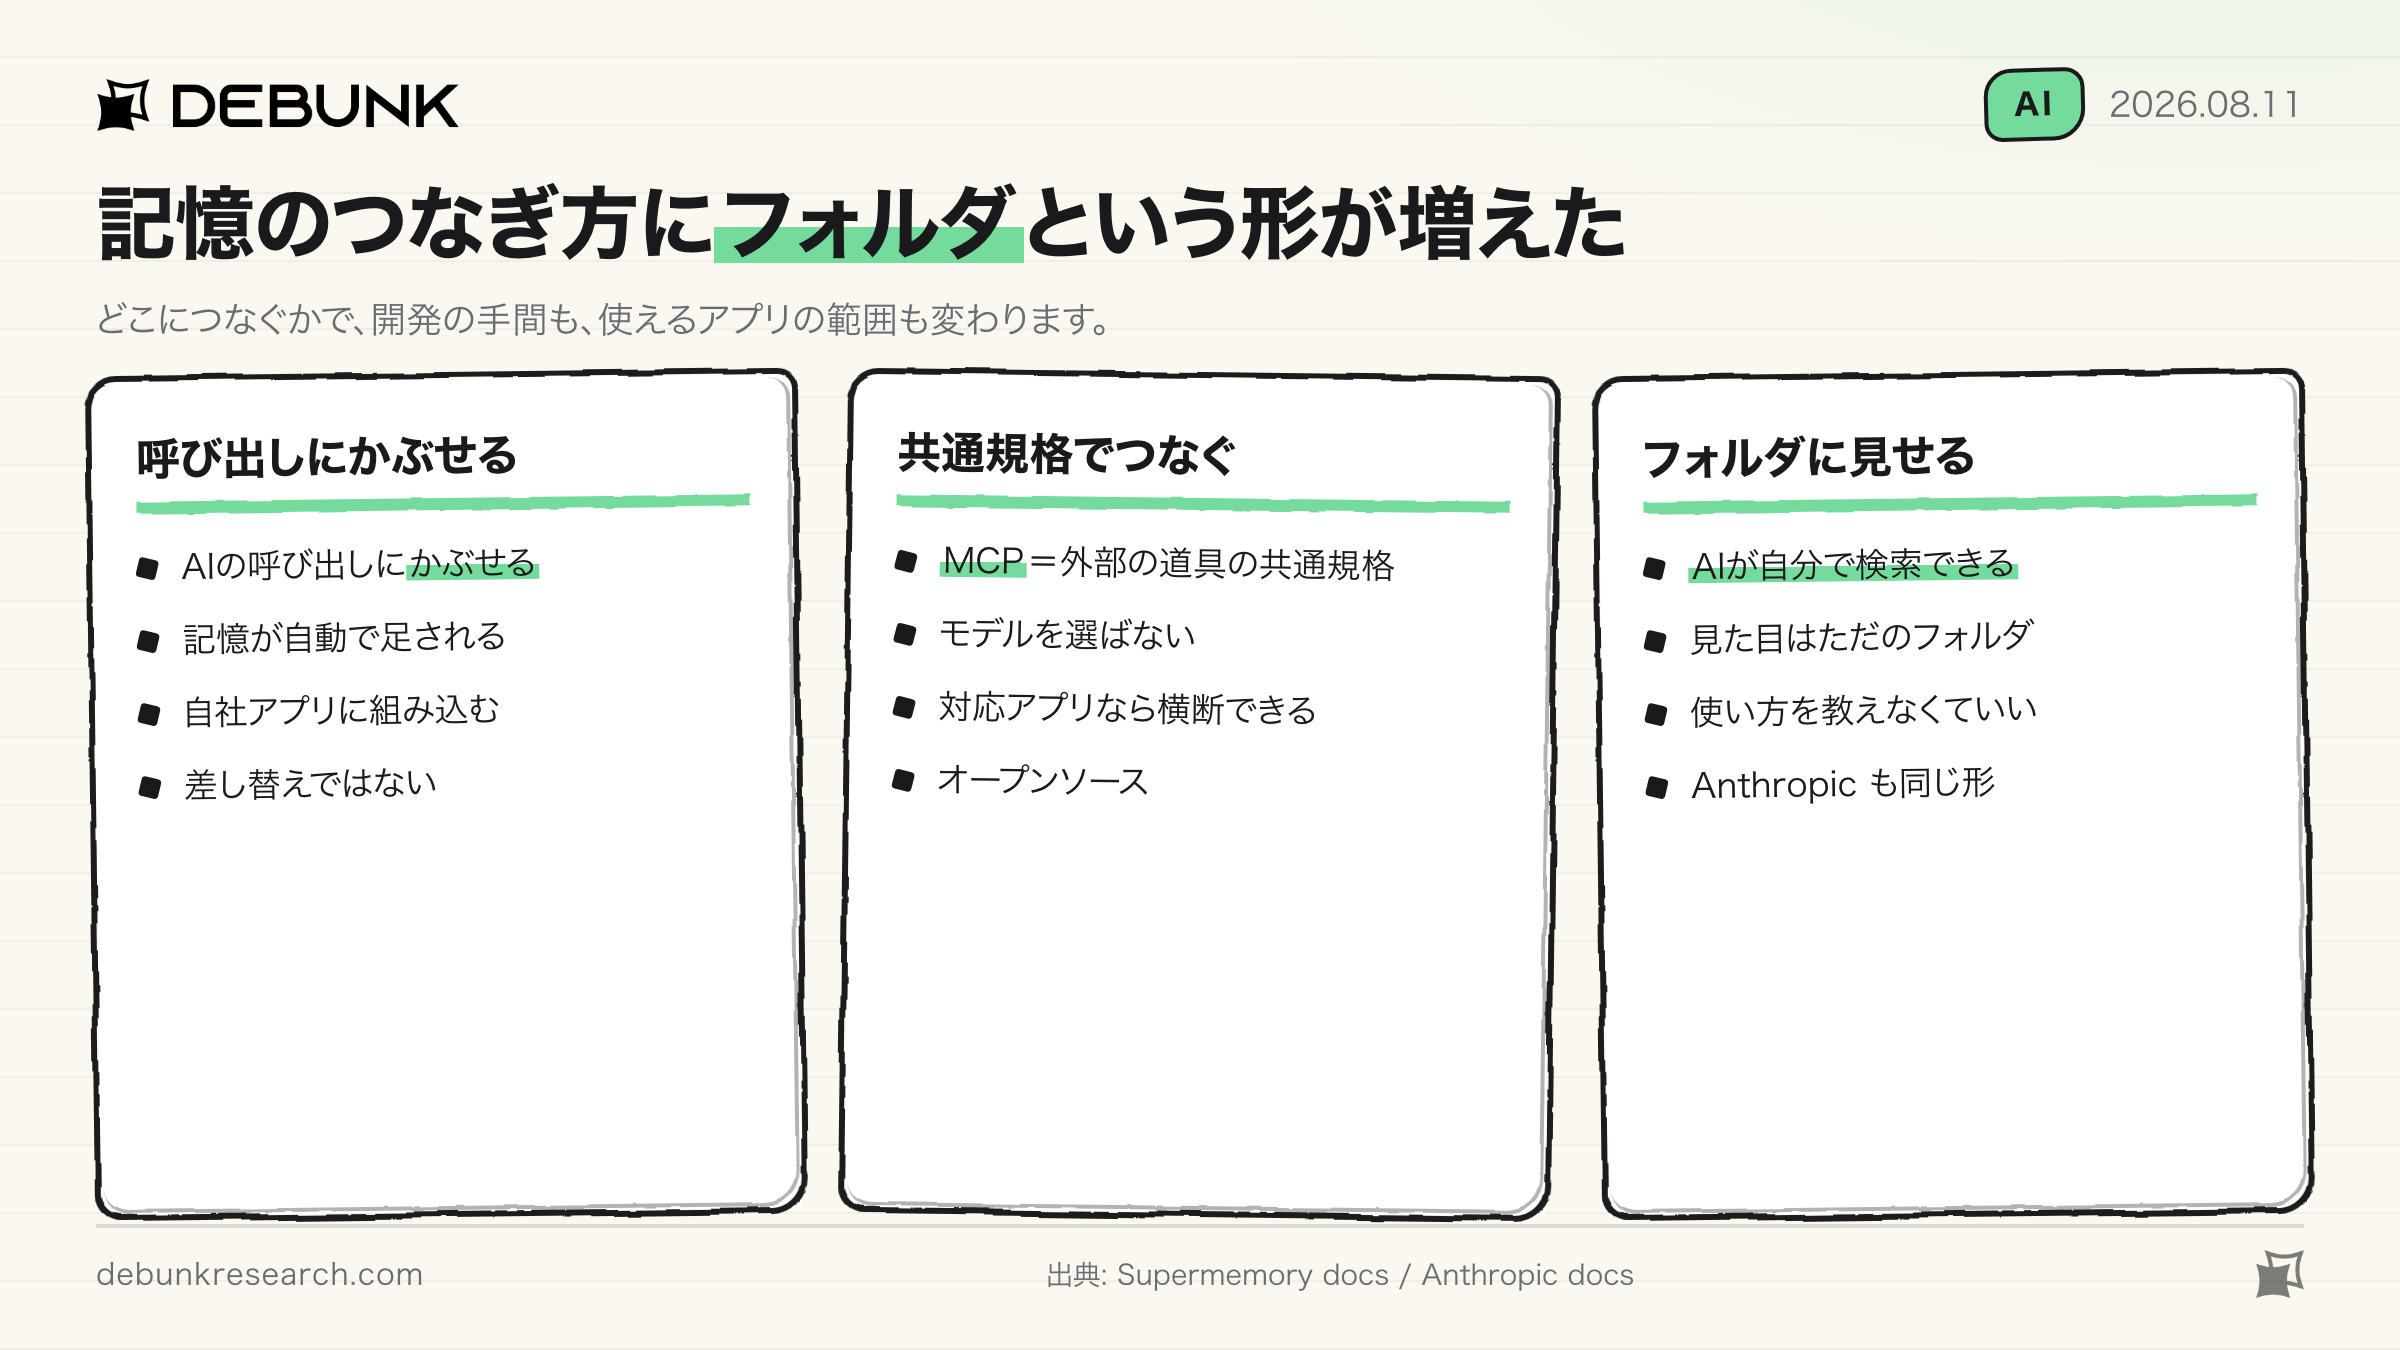
この記憶をアプリのどこにつなぐか。窓口は大きく3つあります。
- 呼び出しにかぶせる:自社アプリがAIを呼び出している部分にかぶせる形で、呼び出しのたびに関係する記憶が自動で足されます
- 共通規格でつなぐ:MCP(AIに外部の道具をつなぐための共通規格)を通して、対応アプリから呼び出す形です
- フォルダとして見せる:記憶をただのフォルダに見せてしまう形で、標語は "Memory your agent can grep."(AIが自分で検索できる記憶)
最近はこの形が増えていて、「どのモデルもファイルの使い方はすでに知っている」ので専用の作法を教えずに済むから、というのが理由だそうです。
どんな場面で効くのか
1. コーディング用のAIに、プロジェクトの決めごとを覚えさせる
Claude Code 向けの接続などが用意されていて、例えば「この処理はこう書く」「ここは触らない」と一度直せば翌週の別の作業でも同じ約束を守らせられるので、毎回おなじ注意書きを貼り直す手間が消えます。
2. チーム全体の共有記憶にする
Company Brain は、チームで記憶を共有する仕組みです。Slack のスレッドや社内ドキュメント、GitHub などをつなぎ、例えば「あの仕様、なぜこう決まったんだっけ」と聞けば当時のスレッドを引いて答えます。権限の扱いも面白く、「Claude Code から聞いても、Slack で聞けないことは出てこない」設計だそうです。
3. 資料検索そのものを置き換える
顧客の声として、Chatarmin の Armin Daryabegi 氏のこの一文が載っており、応答時間もAIに渡す文章量も減ったと添えられています。
We just ditched RAG completely and went memory only through Supermemory.
(RAG を完全にやめて、Supermemory の記憶だけに切り替えました)
変遷|メモリ性能のベンチマークが信用を失うまで
創業背景|Twitterのブックマークと話すツールから
創業者の Dhravya Shah は、Arizona State University を Supermemory に専念するため中退した人物で、10代のうちに自作サービスを売却し、その後はネット基盤大手の Cloudflare で働いていました。
出発点は「毎週なにか新しいものを作る」という個人的な縛りの中で生まれた、「自分のTwitterのブックマークと会話する」だけのツールでした。これが思わぬ数のユーザーを集め、企業から「うちの製品にこの仕組みが欲しい」と声がかかって裏方に回ります。
2025年10月の資金調達は、同じ日の発表なのに一次情報が食い違ったまま残っています。公式ブログは「$3M・pre-seed」、TechCrunch は「$2.6M・seed」で、金額もラウンドの呼び方も違い、評価額はどちらも非公表です。当時19歳だった Shah の初回調達としては金額そのものは大きくありませんが、投資家に Cloudflare のCTOや Google のAI責任者が並んで注目されました。
共通テストが信用を失うまで
ここからが本題です。AIの記憶サービスは横並びで比べにくいので、各社は共通テストの点数を出します。長い会話のあとで前の話を思い出せるか、途中で変わった事実に追随できるかを見る問題集で、模試の点数のようなものです。
この物差しが、壊れます。
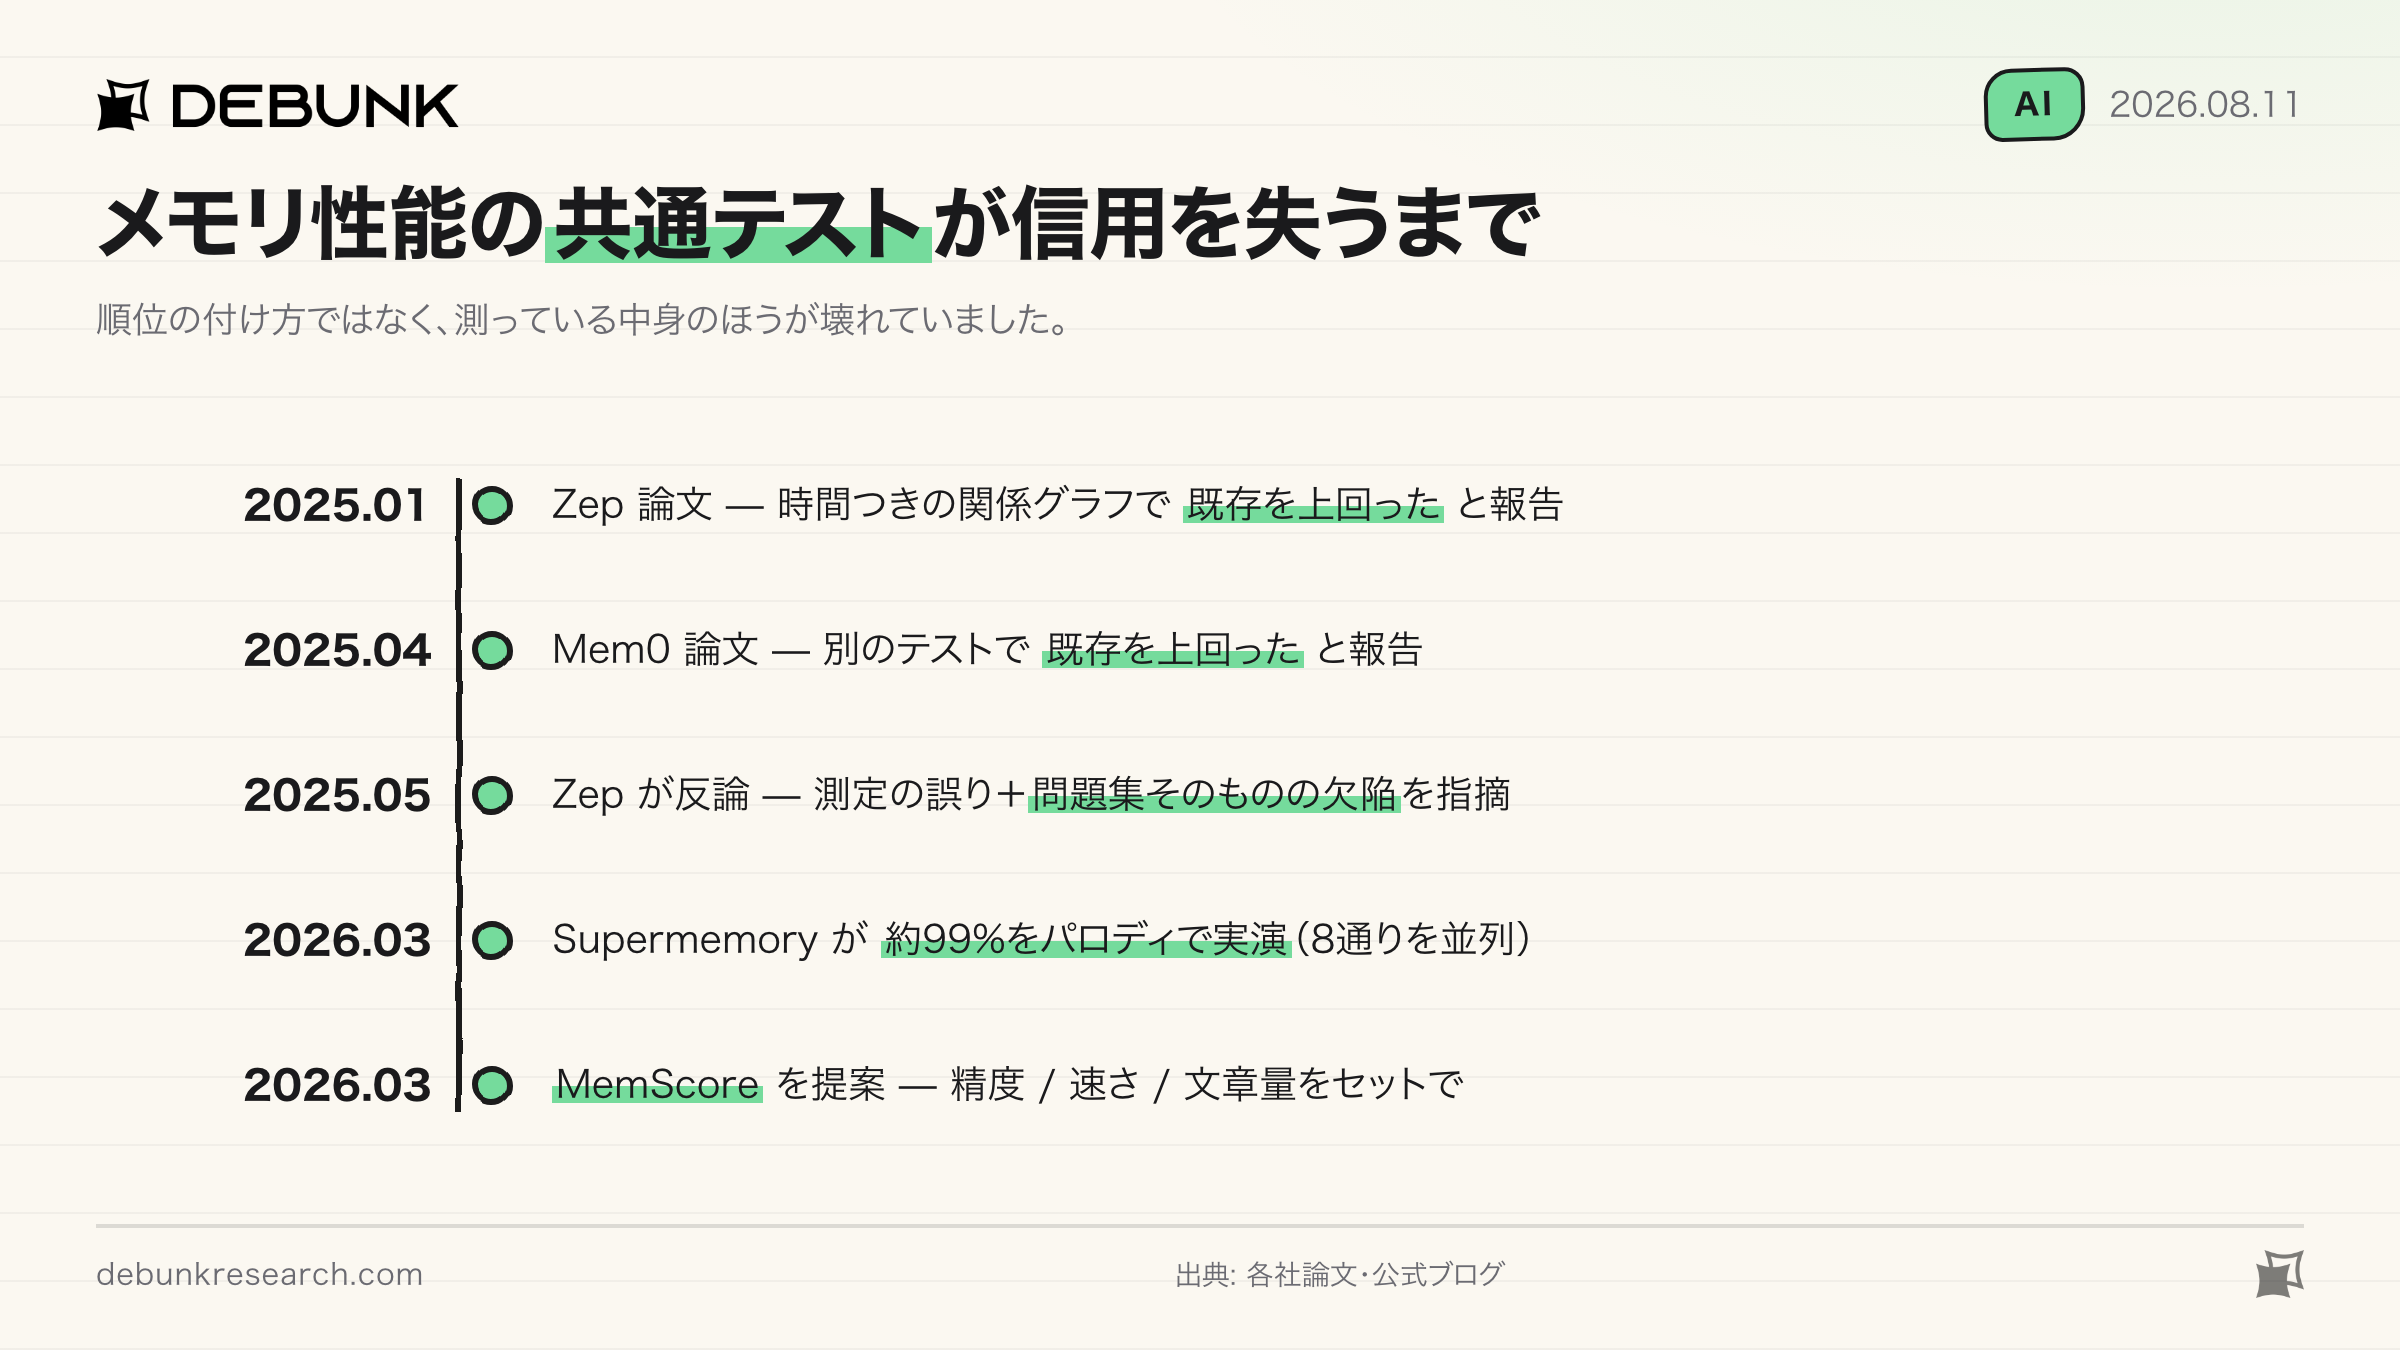
2025年5月、競合の Zep が「嘘、大嘘、そして統計」と題した記事を出しました。Mem0 が LoCoMo というテストで「うちが最高、Zep はこの程度」と発表した測定に、会話の発言者を全員同じ人として登録していた、検索を順番に走らせて Zep の速度を悪く見せていた、といった設定の誤りが複数あるという指摘です。測り直すと Zep の点数は約9ポイント上がっており、誤差ではなく順位がまるごと変わる幅です。
さらに重いのは、同じ記事が問題集そのものの欠陥も挙げたことです。会話が短すぎて長期記憶の試験になっておらず、正解データが無いために両社とも除外したカテゴリもある。測っている対象のほうが壊れていたわけです。
そして2026年3月、Supermemory が決定打を打ちます。「我々はエージェント記憶の限界を突破した」と題して約99%という前人未到のスコアを宣言し、記事の中でこう明かしました。
It was a parody.
(報告の作法を変えるための社会実験でした。これはパロディです)
種明かしはこうです。答え方を変えた8通りの解き方を同時に走らせて、いいとこ取りをした。手間とコストをかければ点数は積み増せる、という実演でした。
代わりに提案したのが MemScore という報告の様式で、精度をひとつ出して終わりにせず、精度・応答の速さ・AIに渡す文章量の3つをセットで書こう、というものです。少しだけ正確でも何倍も遅くて何倍も文章を食うなら「より良い」とは言えない、という理屈ですね。
競合|課金の単位が真逆
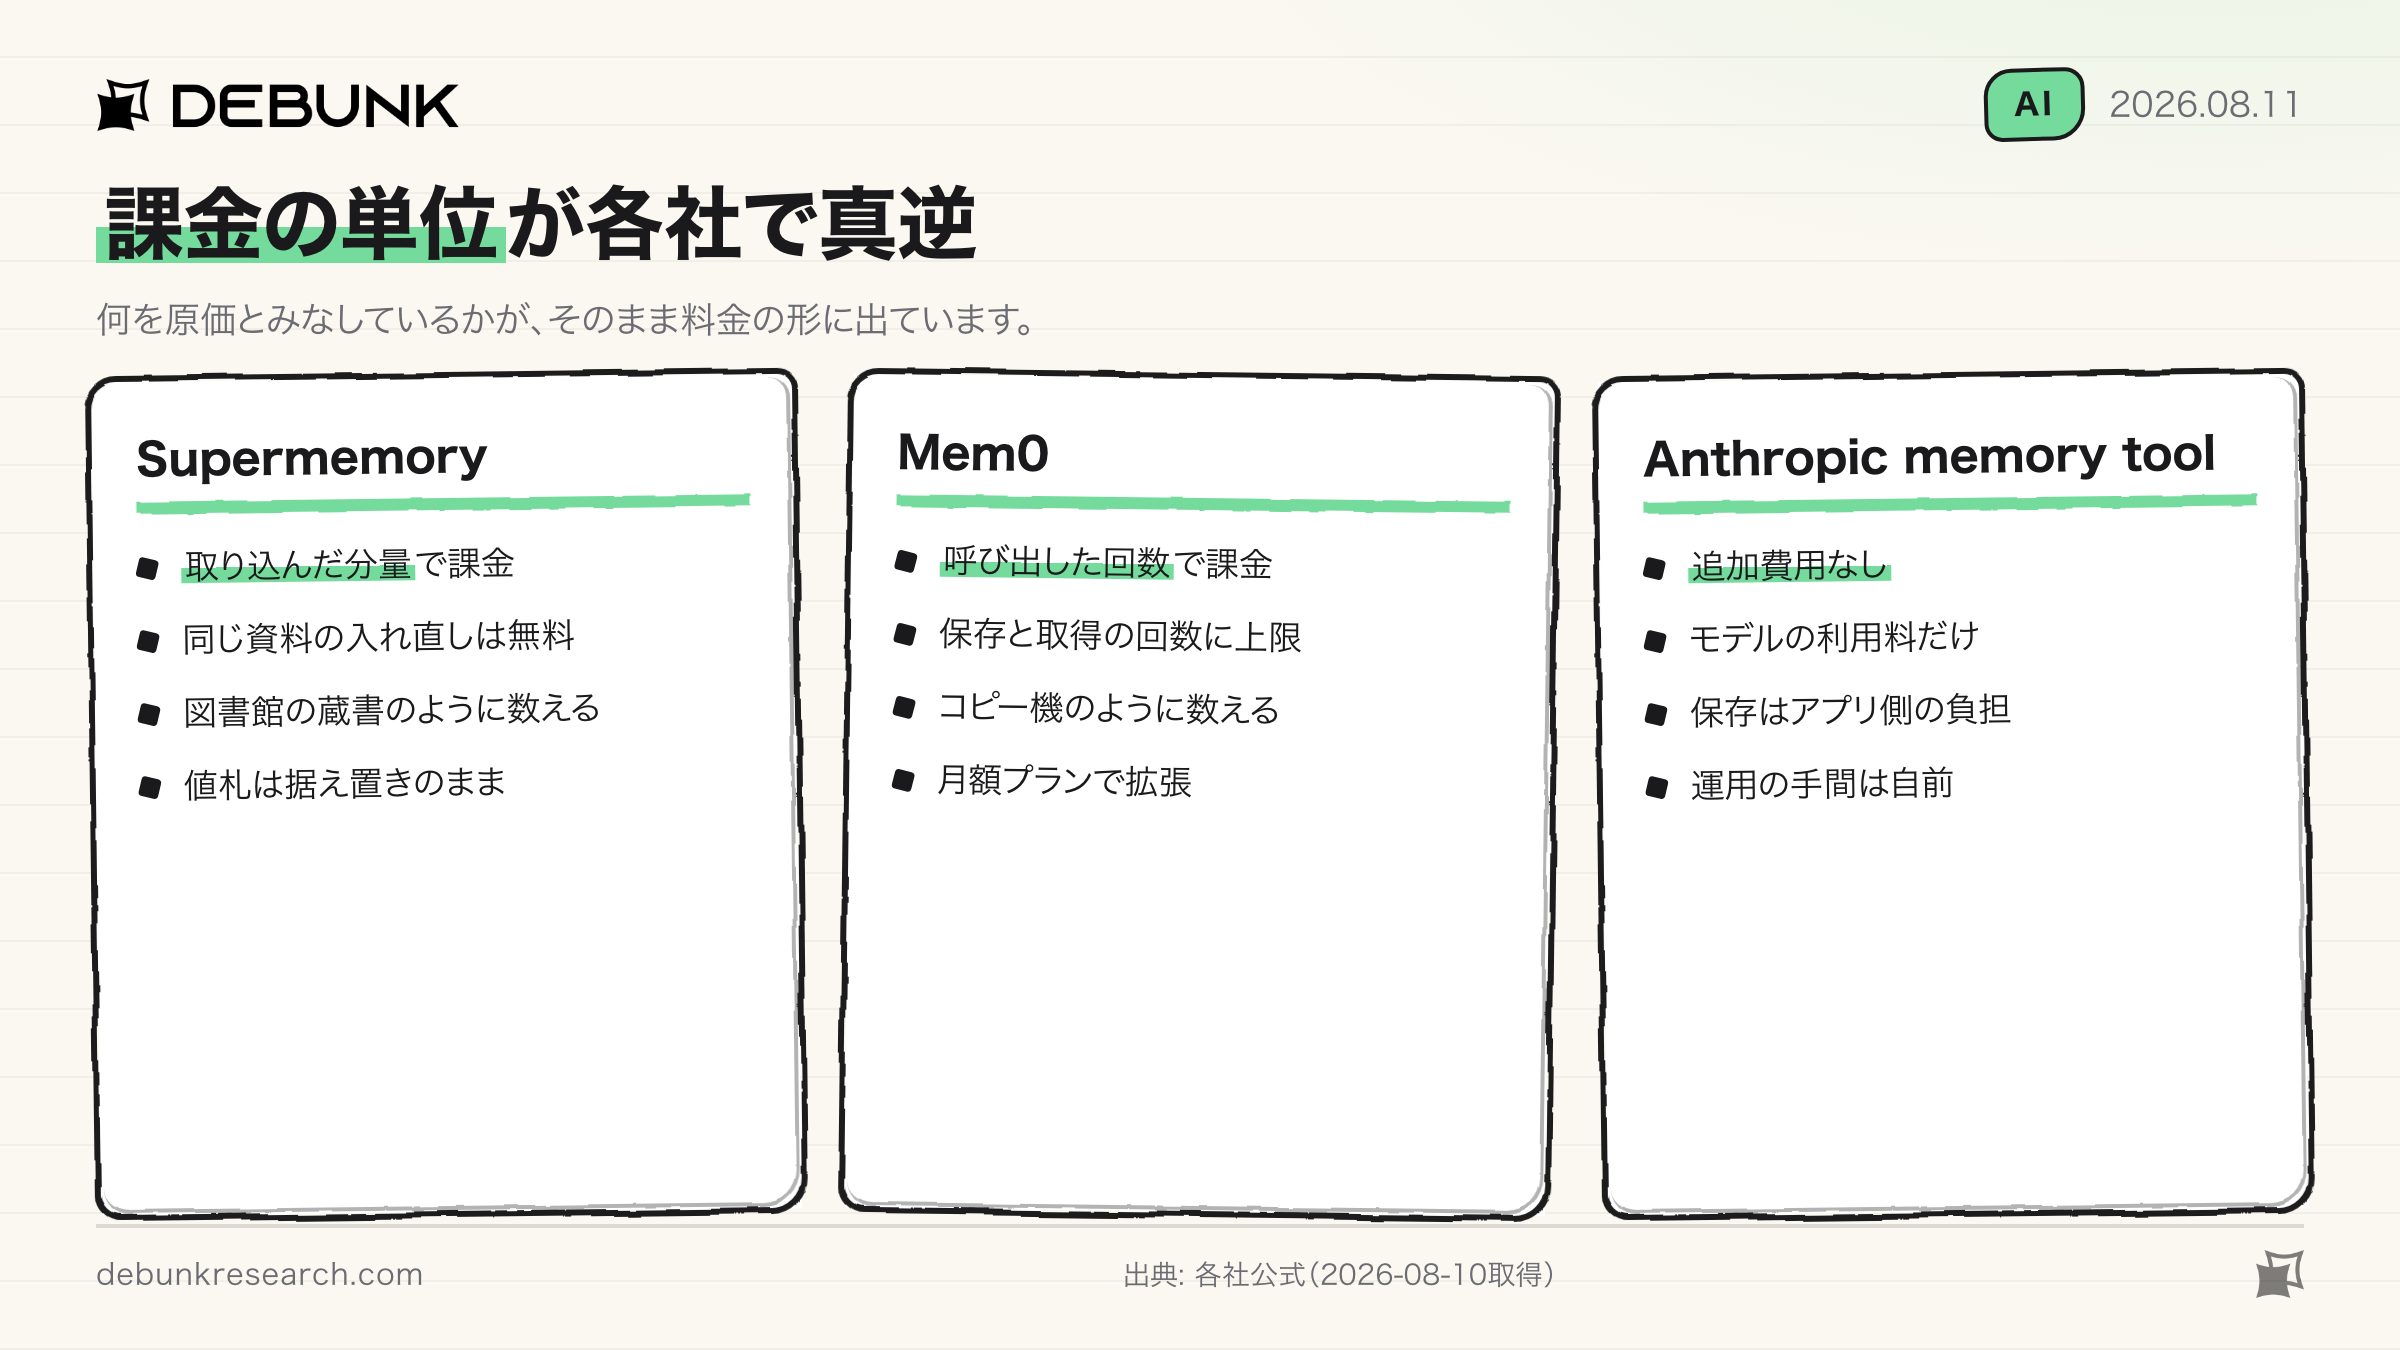
競合との違いも見ておきます。「何を保存して、何に課金するか」で並べると差がはっきりします。
- Supermemory:原文の断片・事実のメモ・カルテを持ち、取り込んで新しく増えた分量ぶんだけ課金
- Mem0:抜き出した事実を持ち、呼び出した回数で課金
- Zep(オープンソース版は Graphiti):事実に「いつからいつまで正しいか」を持たせて管理
- Anthropic の memory tool:決まったフォルダに置いたただのファイルで、費用はモデルの利用料だけ
一番わかりやすいのが課金です。例えば、同じ社内規程のPDFを何度アップロードし直しても、Supermemory では新しく増えた中身のぶんしか請求されません。コピー機のように「枚数×回数」で数えるのではなく、図書館の蔵書のように「持っている本の冊数」で数えるイメージですね。だから「安くなった」と発表したときも、当の同社が「値札は動いていない、動いたのは下の計算だ」と書いています。
考察|壊れていると言った物差しで、1位だと書いている
Supermemory は、このカテゴリで最も誠実な問題提起をした会社だと思います。テストが壊れていることを自ら実演し、代わりの報告様式まで出した。にもかかわらず、トップページに並ぶのは自分が否定した形の数字でした。
「全テストで首位」は自己申告
ベンチマーク欄は「ベンチマークが全てを語るとは思わない」から始まり、次の行が "But we lead every major one anyway."(それでも主要なものは全部うちが首位だ)で、「#1 ON EVERY BENCH」とも出ます。
問題は、これを確かめる先が無いことです。公式の研究ページにあるのはひとつのテストのレポートだけで、各社を同じ条件で測るために同社が公開した道具にも結果の表はなく、現状は検証できない自己申告にとどまります。しかも「速さも一緒に見よう」と提案した当人が、ここでは速さだけを切り出して「Zepの10倍、Mem0の25倍」と語っています。各社が測る「速さ」は中身が揃っておらず、横に並べられるものではありません。
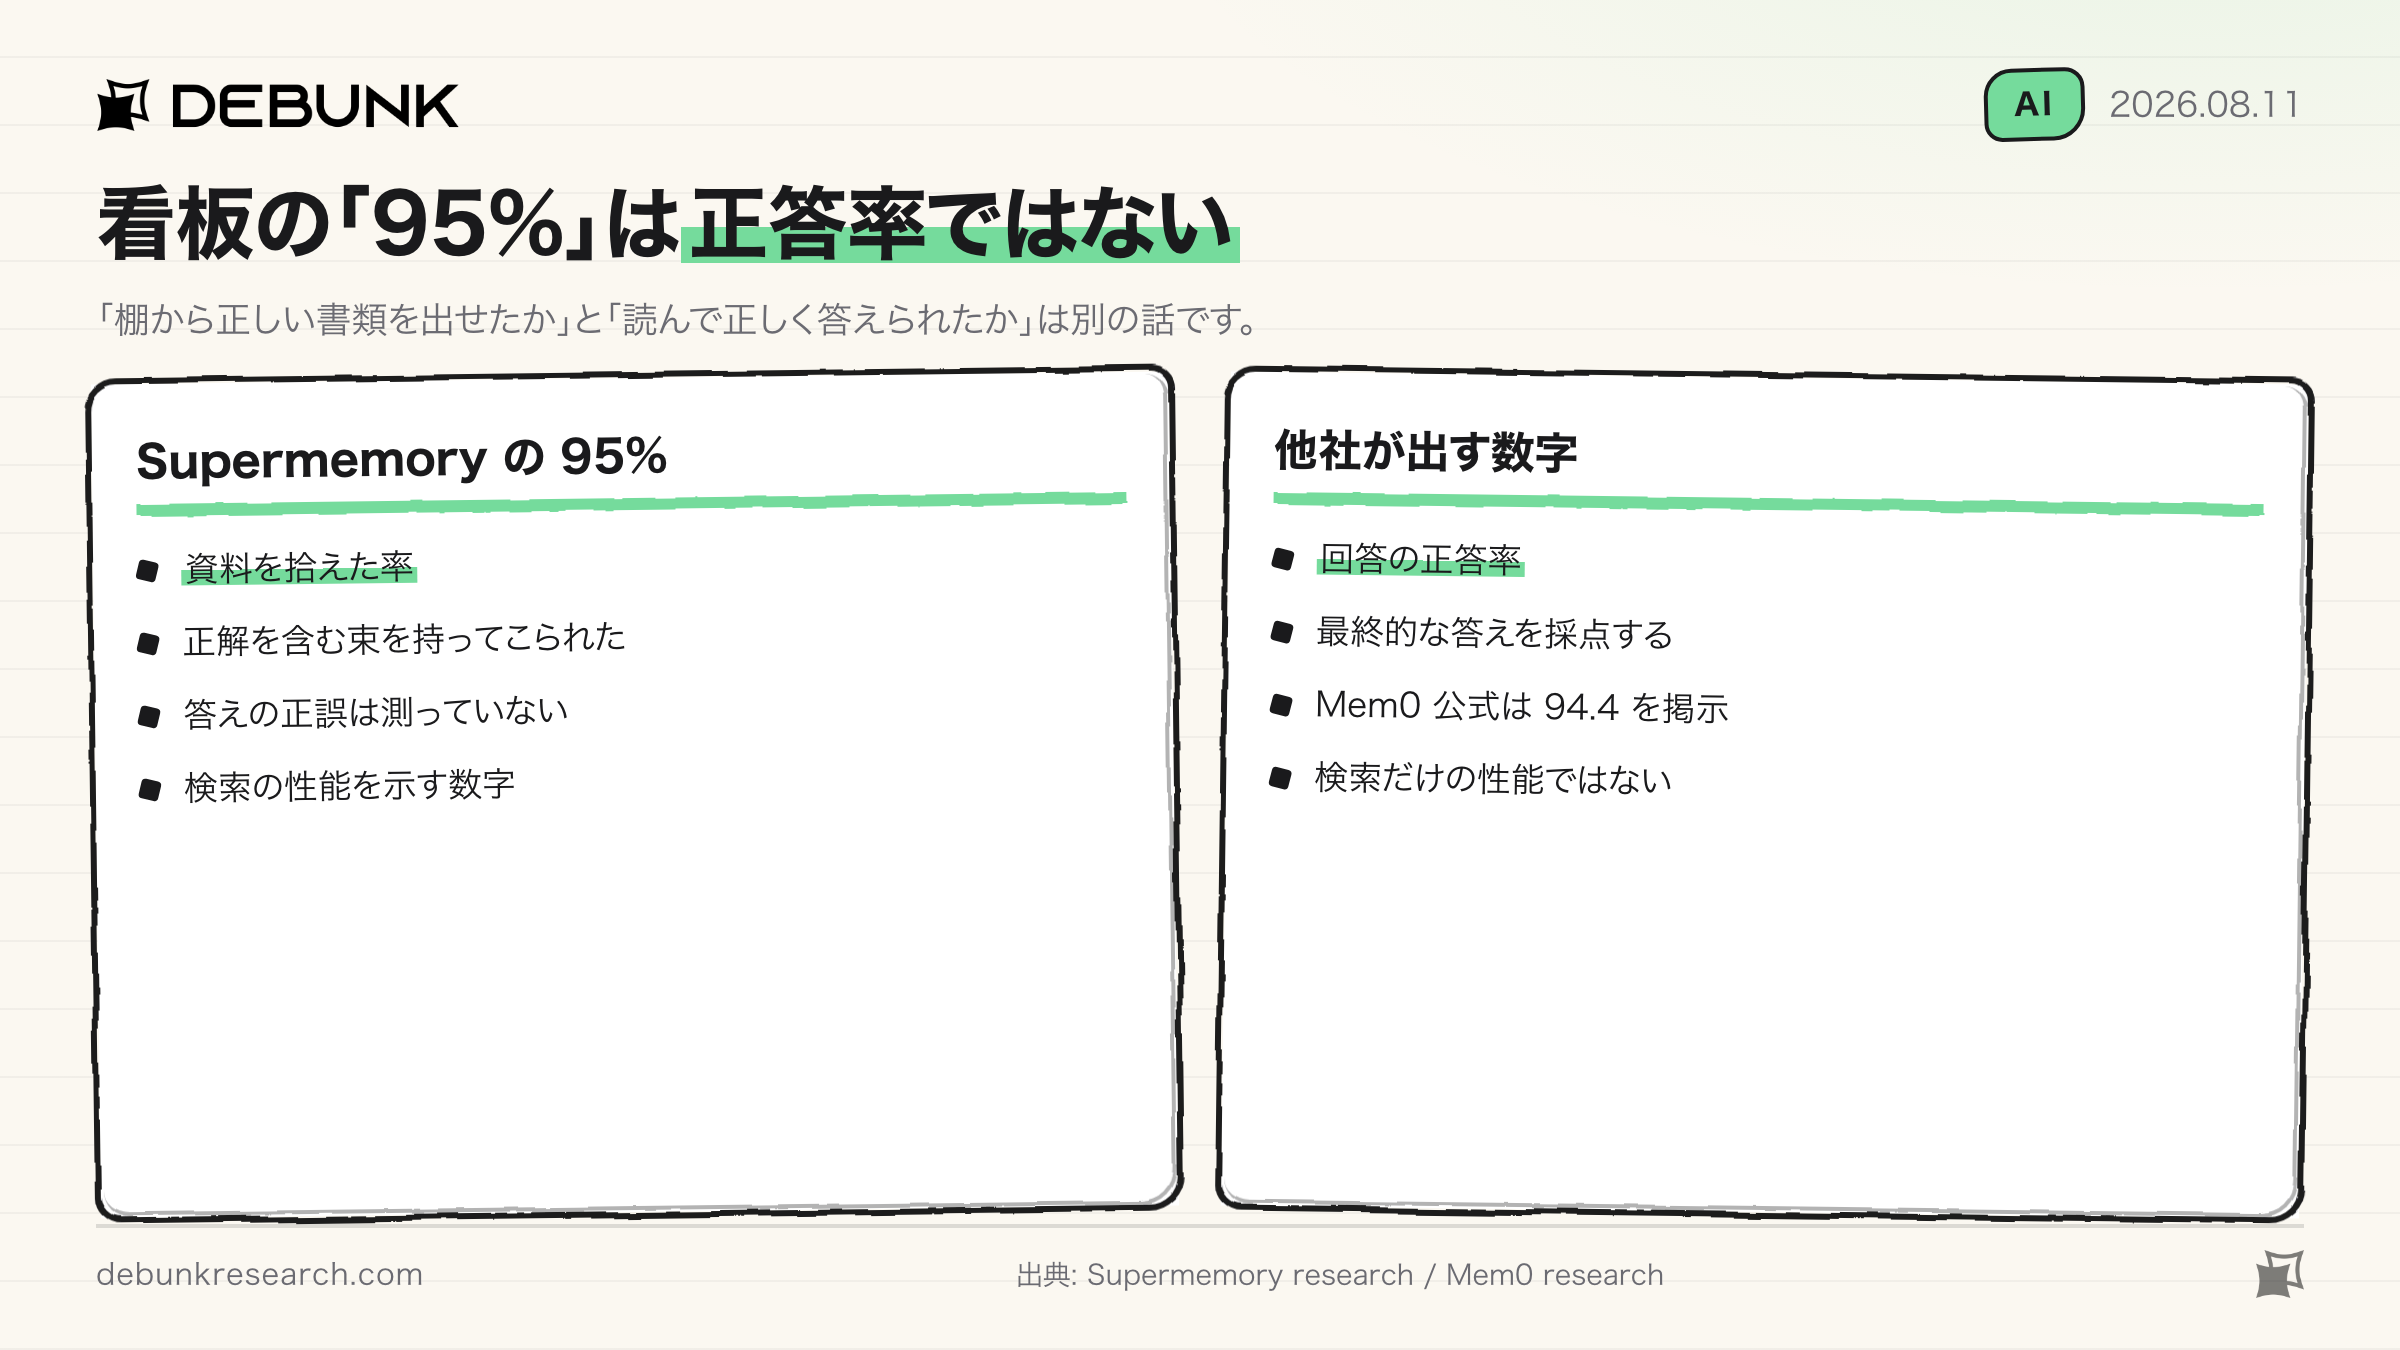
看板の「95%」は、正答率ではない
もう一つ読み違えやすいのが、大きく掲げられた 95% です。
これは検索が、正解の載った資料を上位に拾えた率であって、AIの答えが合っていた率ではありません。例えば社内の問い合わせ対応AIに「育休の申請はいつまで?」と聞いたとして、95%が言っているのは就業規則の該当ページを含む書類の束を正しく引っ張ってこられた割合で、その束を読んだAIが正しく答えられたかは入っていません。さきほどの資料棚のたとえで言えば、棚から正しい書類を抜き出せたところまでの成績ですね。
ややこしいのは、他社が同じテストで出しているのは多くが回答の正答率だということです。Mem0 が公式に掲げる94.4と並べて「うちのほうが上」と読むのは、身長と体重を比べるようなものになります。そもそもレポートに競合のスコアは1つも載っていません。
「プラットフォーマーが取り込んだら終わり」への反論
「Anthropic のような開発者向けの基盤が標準機能として持ったら、記憶のスタートアップは要らなくなる」とよく言われますが、Anthropic の memory tool のドキュメントには逆に近いことが書いてあります。
Memory lives entirely in your application.
(記憶は、完全にあなたのアプリケーションの中に置かれます)
Claude ができるのは「このファイルを読んで」「書き換えて」と要求することだけで、実際に保存するのも、誰に見せてよいかを管理するのも、アプリを作る側の仕事です。標準化されたのは保存の場所ではなく保存の作法(ファイルとして持て)で、中身の面倒を見る仕事は外に残っています。
そして Supermemory には、この memory tool とつなぐためのページがあります。その裏側に自分を挿す構えで、標準が決まることは飲み込まれることと同義ではありません。
気になる点
- 推測して書き込む設計:AI企業 Writer の研究では、誤った理解が記憶に残ると後続の精度が落ちる結果が出ています。例は「おそらく」付きですが、その留保がAIに渡るときまで保たれるかは見えません
- 比較対象の省略:フォルダ型の発表で掲げた「55%安い」の比較対象は、Mem0 でも Zep でもなく、記憶サービスを使わずファイルだけを持たせたエージェントです。数字は真っ当なのに競合比に読めてしまいます
- 自己申告の集中:処理量も保存件数も利用者数も同社の開示だけで、外から確かめる手段がありません
個人的な見解
個人的には、この会社の面白さは製品よりも立ち位置にあるのだと思っています。テストが壊れていると分かっていても、看板に順位を書かないと売れない。MemScore を出した当人ですら順位に戻るあたりに、この市場の温度が出ているように感じました。
ここから引き出せる教訓は「ベンダーの自己申告は当てにならない」ではありません。それは正しくても、代わりに何を見ればいいかを教えてくれないからです。もう一段降りると、問題は個社の誠実さではなく物差しを作る人と使う人が同じことのほうにあり、壊れているのは報告の様式のほうだと思います。
同じ構造は記事の外にもあります。例えば企業の格付けは、多くが格付けを受ける企業の側から手数料を受け取る仕組みで、金融危機のときに利益相反が批判されました。測る人と測られる人が分かれるまで、点数は営業資料の一部であり続けます。AIの記憶もいま、その手前にいるのだろうと見ています。
1つの懸念は、この状態がしばらく続きそうなことです。記憶の良し悪しは使い込んでから効いてくる性能なので、短い試用では差が出ません。物差しが整うのは、AIエージェントの導入が一巡する2027年くらいではないかと予想しています。
そのあいだ、検討する側がやることは順位表を見比べることではありません。見るべきは3つだけです。何を覚えるのか(断片か、事実のメモか、ファイルか)、どこにつなぐのか、何に課金されるのか(呼び出し回数か、取り込んだ分量か)。どれも公式ドキュメントに書いてあり、点数の盛り方に左右されません。
見どころは、MemScore に他社が乗るかどうかです。乗れば報告の様式が動いた証拠になりますし、乗らなければあのパロディは自社の宣伝だったということになります。
Supermemory は業界の作法そのものを変えにいった会社なので、今後も追いかけていきます!
以上、「Supermemory」のリサーチでした!