目次
おはようございます。
今日は「DeepSeek V4 Flash 0731」をリサーチしました。
TL;DR
- 2026年7月31日公開。実は新しいモデルではなく、4月の V4-Flash-Preview とアーキテクチャもサイズも同一で、変わったのは事後学習だけ。284B総 / 13Bアクティブの MoE、100万トークン文脈、MITライセンスです
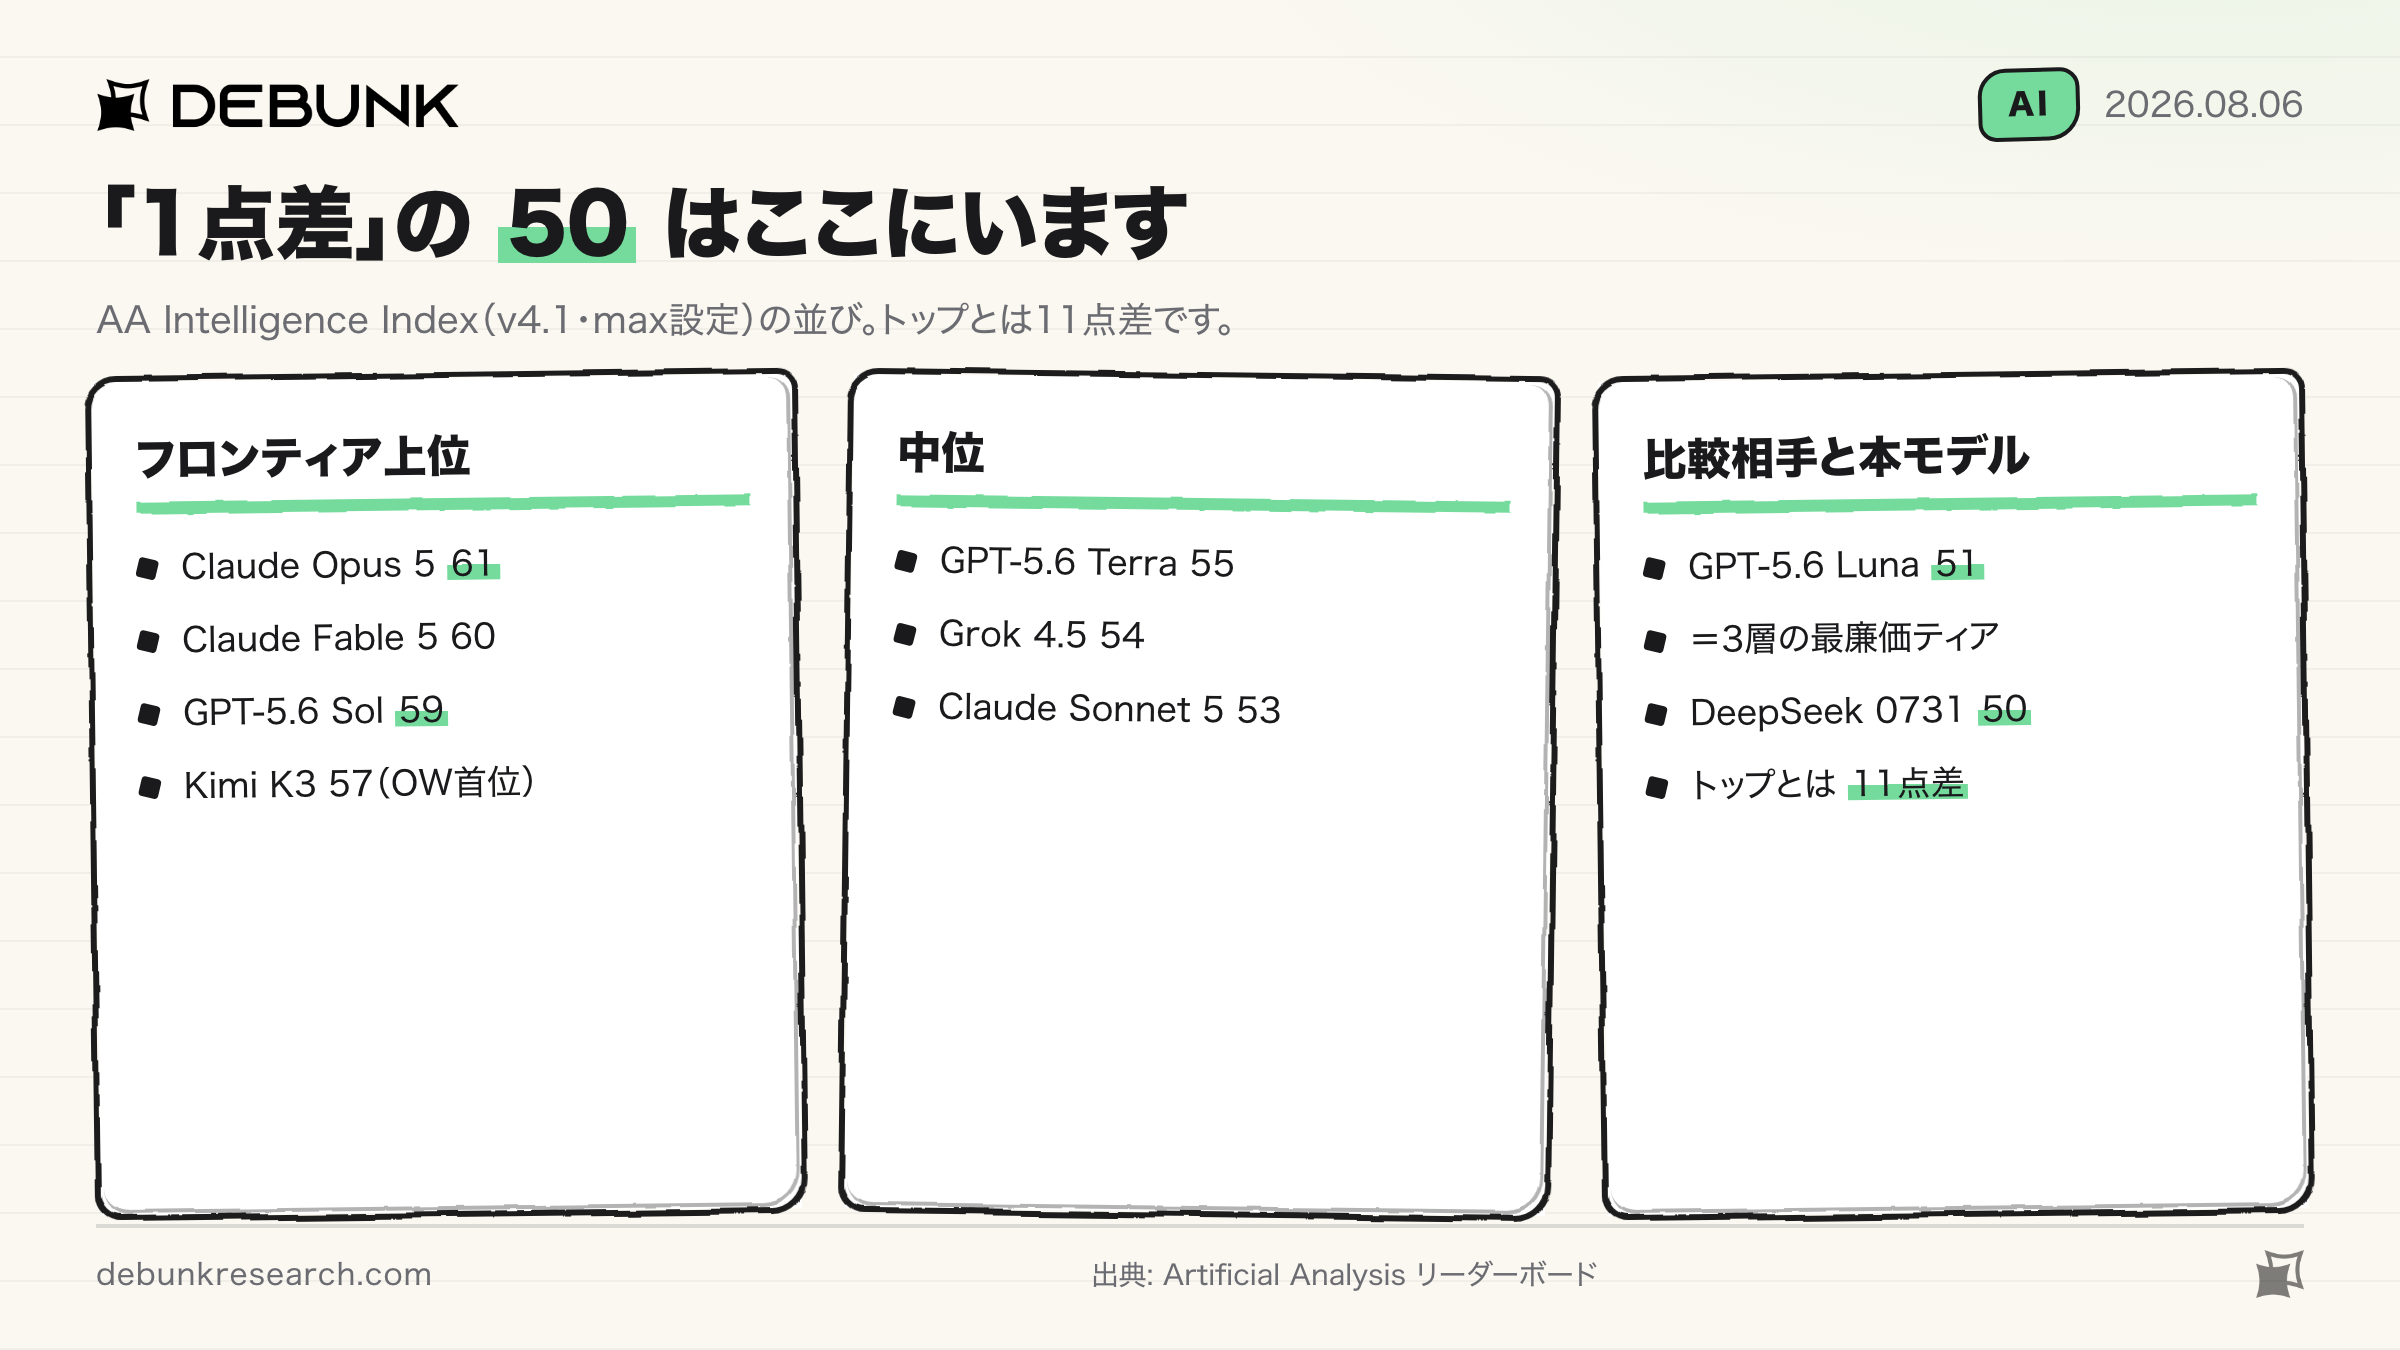
- Artificial Analysis の Intelligence Index で 50。「GPT-5.6 Luna に1点差」と報じられましたが、Luna は OpenAI の3層のうち最も安い最下位ティア。全体リーダーボードでは50は上位15位圏外・トップとは11点差です
- 一方で安さのほうは本物。同じ Index の走破に DeepSeek は $72.02、Luna は $190.87 で実測 62.3%安。ただし安全性評価は上位の V4-Pro を対象にしたものしかなく、Flash 0731 の第三者評価は見つかりません
概要|DeepSeek V4 Flash 0731とは?
DeepSeek V4 Flash 0731 は、中国の DeepSeek が2026年7月31日に公開したオープンウェイトの大規模言語モデルです。名前どおりの日付リリースなのですが、公式ドキュメントの書きぶりが少し変わっています。
DeepSeek-V4-Flash-0731 keeps the same model architecture and size as DeepSeek-V4-Flash-Preview, and was only re-post-trained.
(アーキテクチャもサイズも4月の V4-Flash-Preview と同じで、事後学習をやり直しただけ)
つまり新しい基盤モデルではありません。事前学習(pre-training/大量のテキストを読ませる工程)はそのままで、事後学習(post-training/指示に沿わせたり推論を鍛えたりする仕上げの工程)だけを再実行したものです。API のモデル名も deepseek-v4-flash のまま。この「作り直したのは仕上げだけ」という事実は、記事の最後にもう一度効いてきます。
中身|256人の専門家から、毎回6人だけ呼ぶ
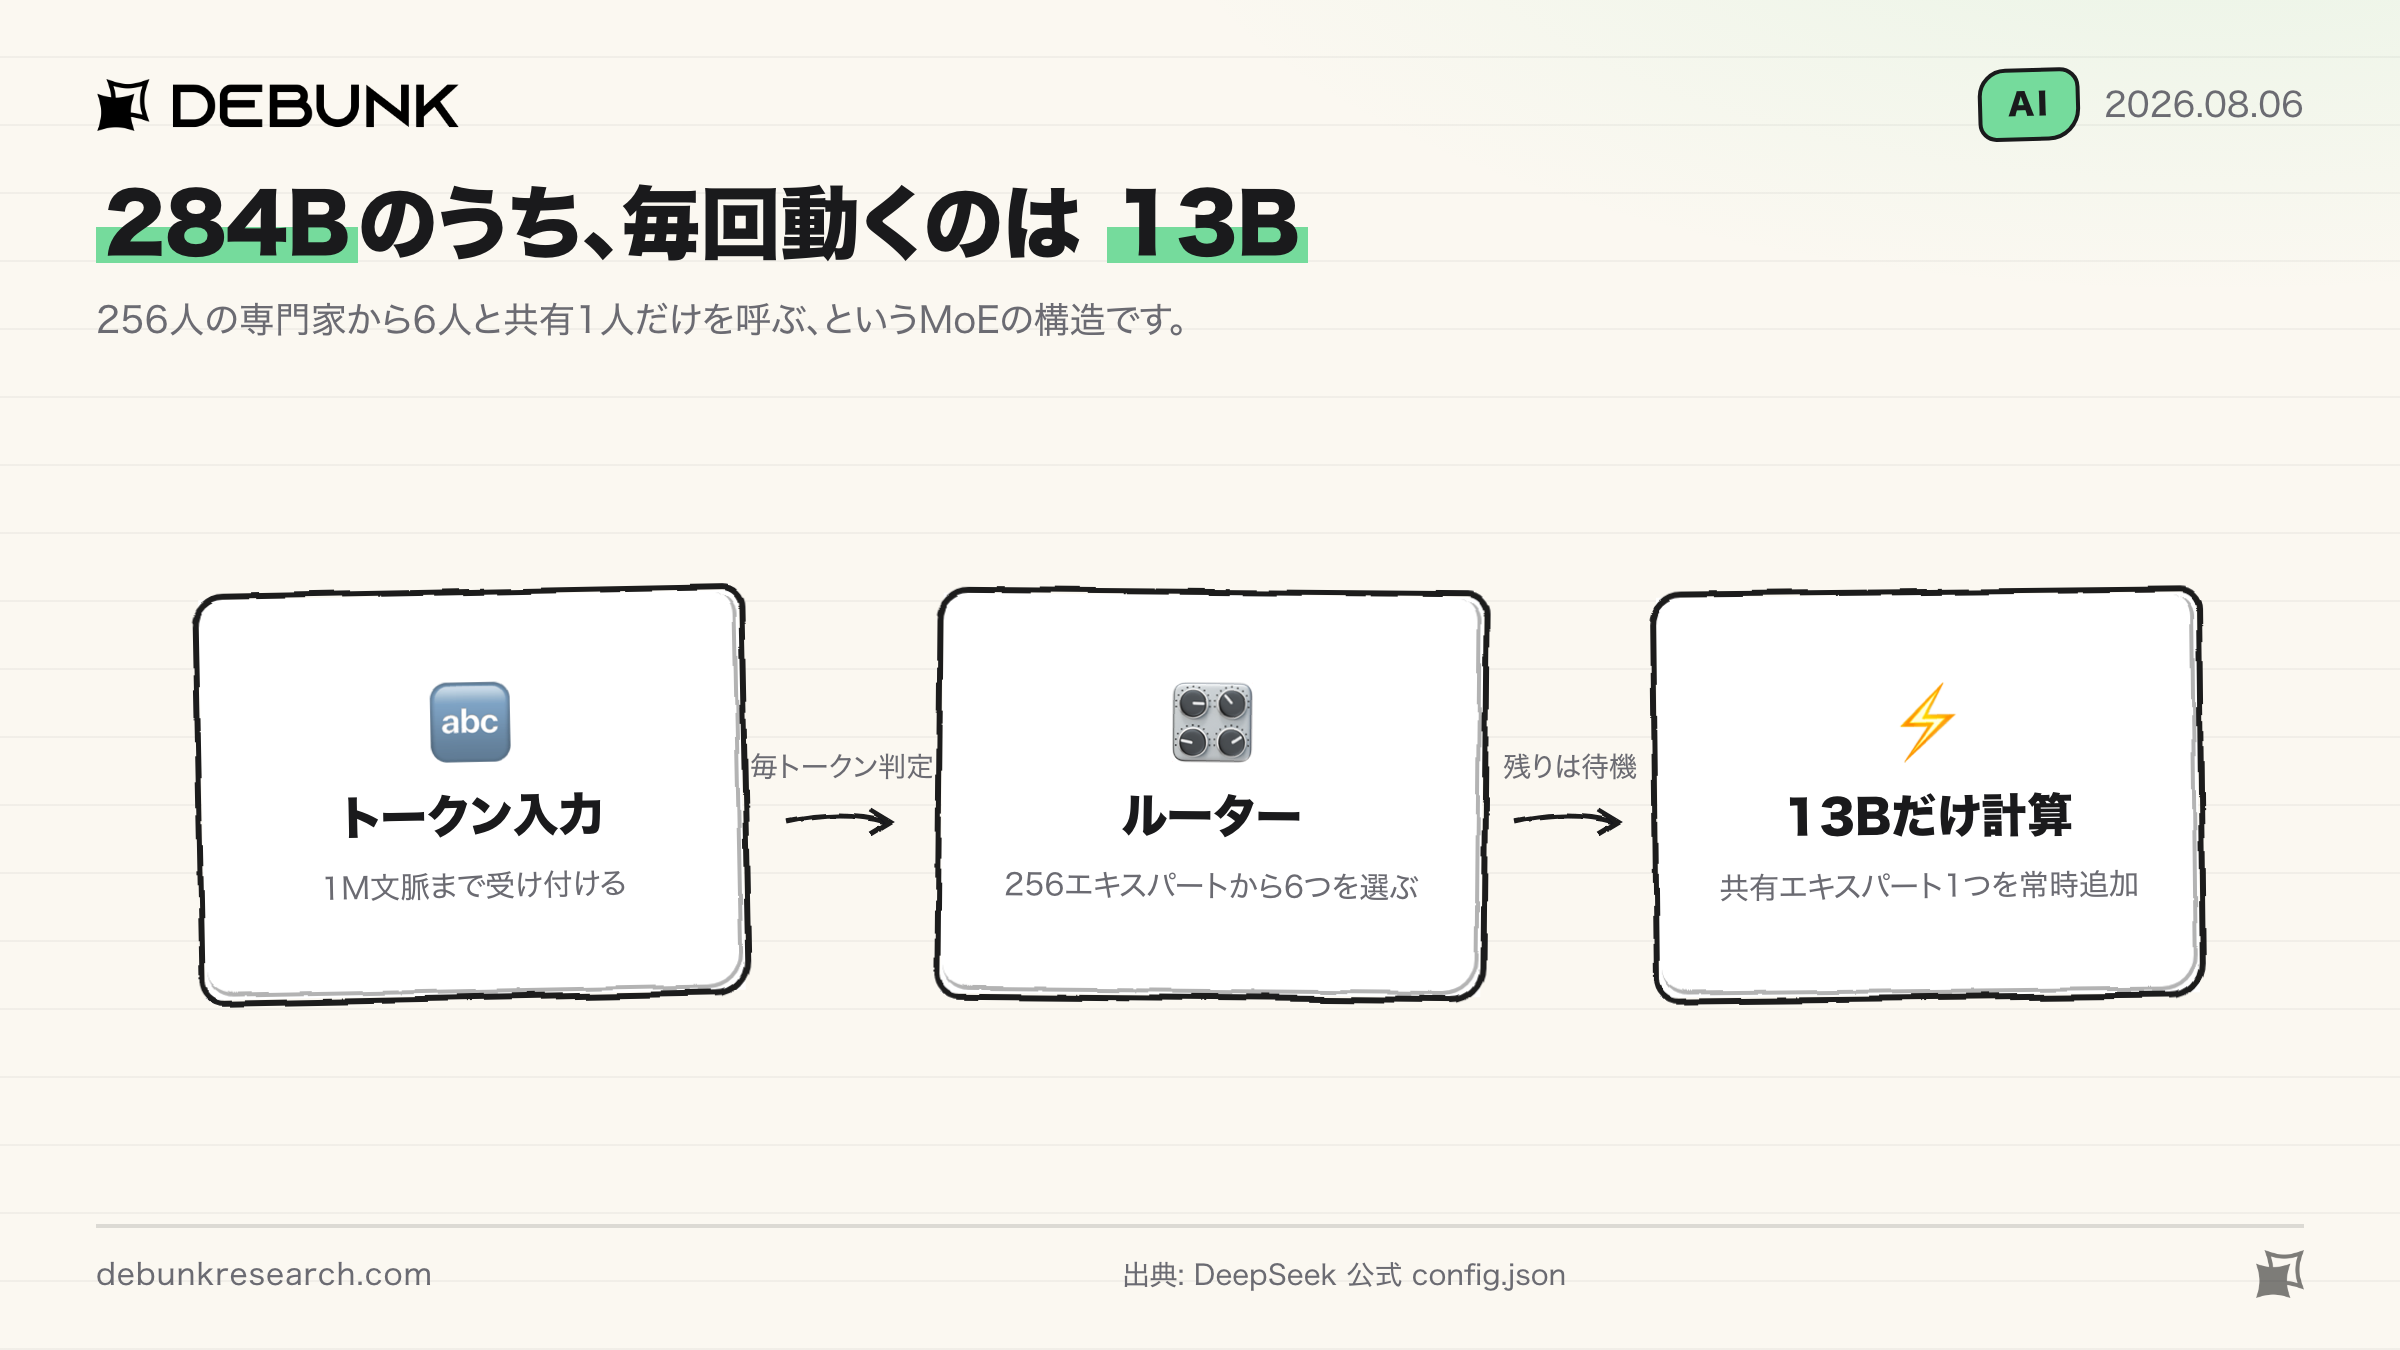
パラメータは公式表記で 284B総 / 13Bアクティブ。MoE(Mixture of Experts/専門家混合)、つまり巨大なモデルの中に多数の「専門家」を持たせ、トークンごとに一部だけを起動する方式です。上位の V4-Pro は 1.6T総 / 49Bアクティブなので、Flash はおよそ1/6の規模になります。
公開されている config.json によれば、層は43、ルーティング先のエキスパートは256、1トークンあたりに選ばれるのは6つ、加えて常時起動の共有エキスパートが1つ。256人の専門家のうち毎回6人と司会1人だけが喋る、というイメージですね。
文脈長は 100万トークン。ネイティブの65,536トークンを YaRN(位置情報の表現を引き伸ばす手法)で16倍に拡張したもので、公式は「1M context is now the default across all official DeepSeek services」と全サービスの既定値にしたと述べています。
ライセンスはモデルカード原文で「This repository and the model weights are licensed under the MIT License.」。リポジトリと重みの両方が MIT です。R1(2025年1月)以来の一貫路線で、商用利用の制約という意味では最も緩い部類に入ります。
価格|98%引きのキャッシュと、予告された「ピーク時2倍」
公式APIの価格は100万トークンあたり input $0.14(キャッシュミス)/ $0.0028(キャッシュヒット)/ output $0.28。V4-Pro が $0.435 / $0.003625 / $0.87 なので、Flash はおよそ1/3です。
目を引くのはキャッシュヒット時の $0.0028 で、定価のちょうど2%、つまり98%引き。業界標準はおよそ90%引きなので、ここだけ突出しています。長い仕様書を頭に置いて何十回も質問するような使い方では、効き方がまるで変わります。
ただし価格ページには注意書きが付いています。「During peak hours, prices will be 2x the regular prices, applicable to all billing items.」——北京時間の 9:00–12:00 と 14:00–18:00 は全課金項目が2倍という予告で、適用開始日は未発表。日本時間もほぼ同じ帯なので、表示価格をそのまま計画に入れるのは危ないところです。
スコア|話題になった「1点差」の中身
そして話題になった数字が、Artificial Analysis(以下AA)の Intelligence Index 50 でした。AAは「4月の V4 Flash から10点ジャンプ」「V4-Pro より6点上」「GPT-5.6 Luna(51)に1点差」と書いています。
このIndexは9つの評価を加重平均した合成指標で、配分はエージェント34%(GDPval-AA v2 が20%、τ³-Banking が14%)、コーディング24%、科学的推論24%、一般18%。テキストのみ・英語のみが対象です。そしてこの1点差が、今日の主題になります。
変遷|3週間で一周した2026年7月
創業背景|AIラボになる前からGPUを買い込んでいた
DeepSeek の親会社は High-Flyer(幻方)というクオンツヘッジファンドで、2015年6月の創業。共同創業者の梁文鋒(Liang Wenfeng)は浙江大学出身です。DeepSeek 自体は2023年7月17日にAGI研究部門としてスピンアウトし、High-Flyer が筆頭出資者かつオーナーのまま今に至ります(このあたりは二次情報が中心です)。
重要なのは、AIラボとして生まれる前からGPUを買う財布があったことです。2019年から2022年にかけて、輸出規制が本格化する前に自己勘定の利益から1.39億ドル超を投じてスパコン「Fire-Flyer」を組み、Nvidia A100を1万基超確保したと報じられています(※一次ソース未取得)。
そして2024年12月のV3、2025年1月20日のR1(MITライセンス)。R1公開の1週間後、2025年1月27日に Nvidia 株は17%下落し、時価総額およそ5,930億ドルが消えました。当時としては史上最大の1日下落です。これが第1サイクルでした。
業界の循環|7月9日から31日までの3週間
今回のリリースは、単体で見れば「小型モデルの事後学習アップデート」でしかありません。ですが7月に何が起きていたかを並べると、意味が変わります。
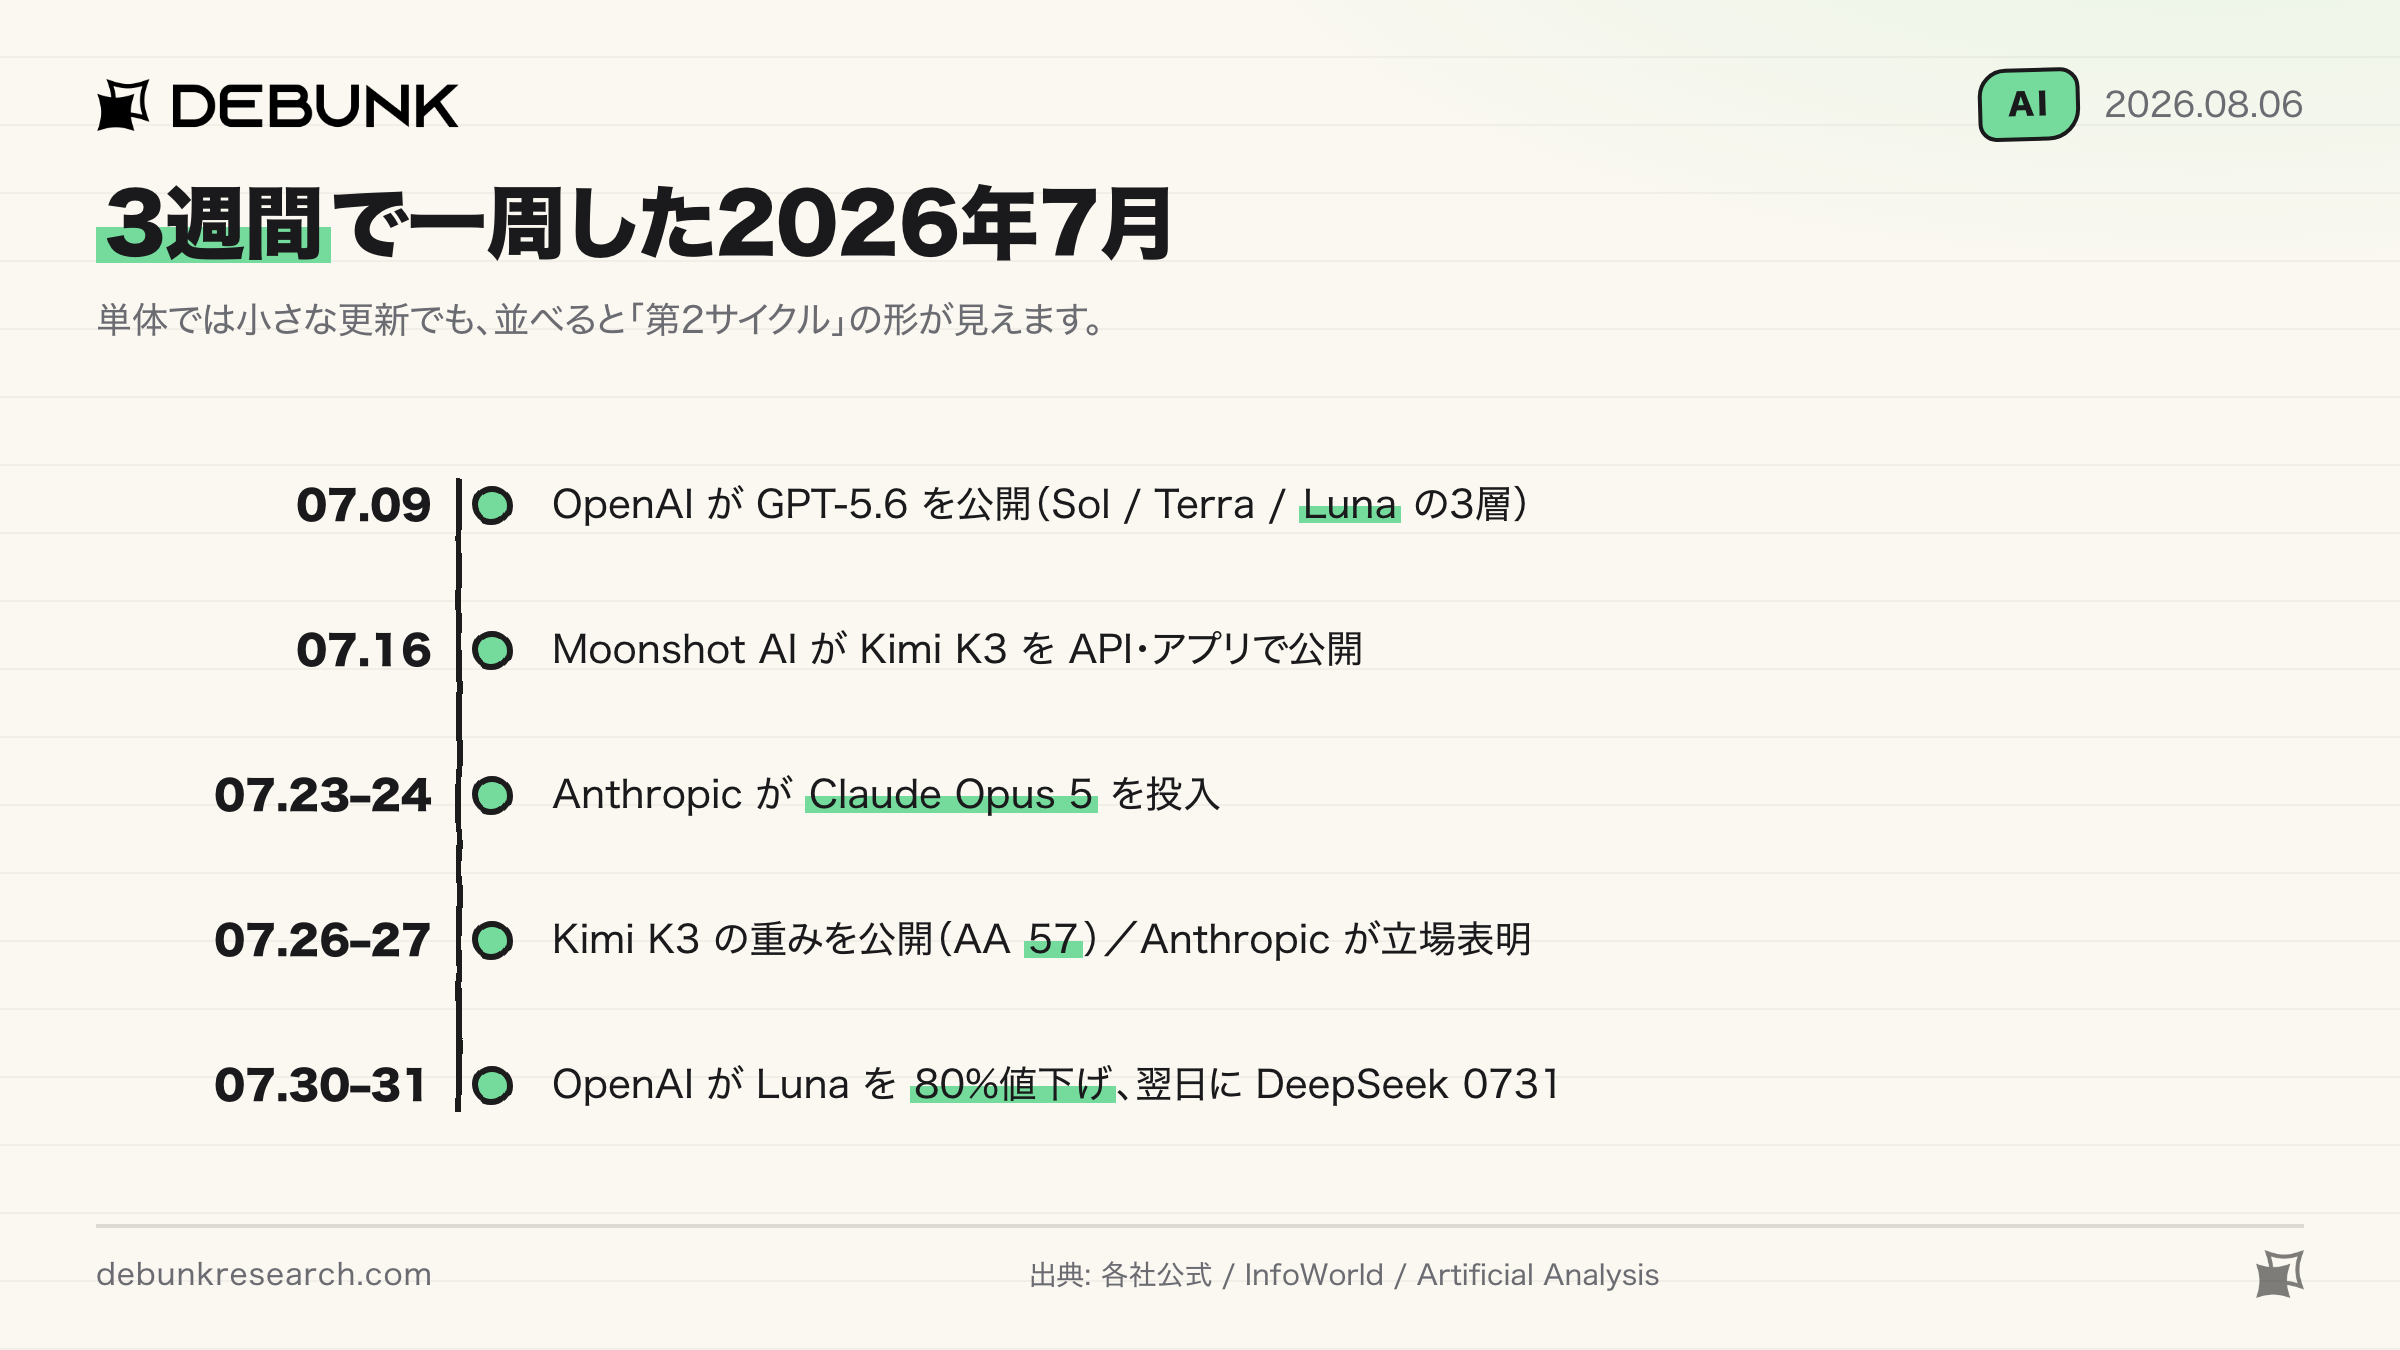
- 7/9 OpenAI が GPT-5.6 を一般公開。Sol / Terra / Luna の3層構成
- 7/16 Moonshot AI が Kimi K3 を API・アプリで公開
- 7/23–24 Anthropic が Claude Opus 5 を投入
- 7/26 Moonshot が Kimi K3 の重みを予定より1日早く公開。2.8T総パラメータ・1M文脈で、公称では最大のオープンウェイト。AA Intelligence Index 57で同カテゴリ首位
- 7/30 OpenAI が Luna を最大80%値下げ。input $1 → $0.20、output $6 → $1.20(Terra は −20%)
- 7/31 DeepSeek V4 Flash 0731
OpenAI 側の説明は「serving efficiency の改善」で、中国勢への言及はありません(※価格ページが403で一次確認できず、報道ベースです)。ただ、値下げの翌日に中国勢が1点差のスコアを出した、という並びは残ります。
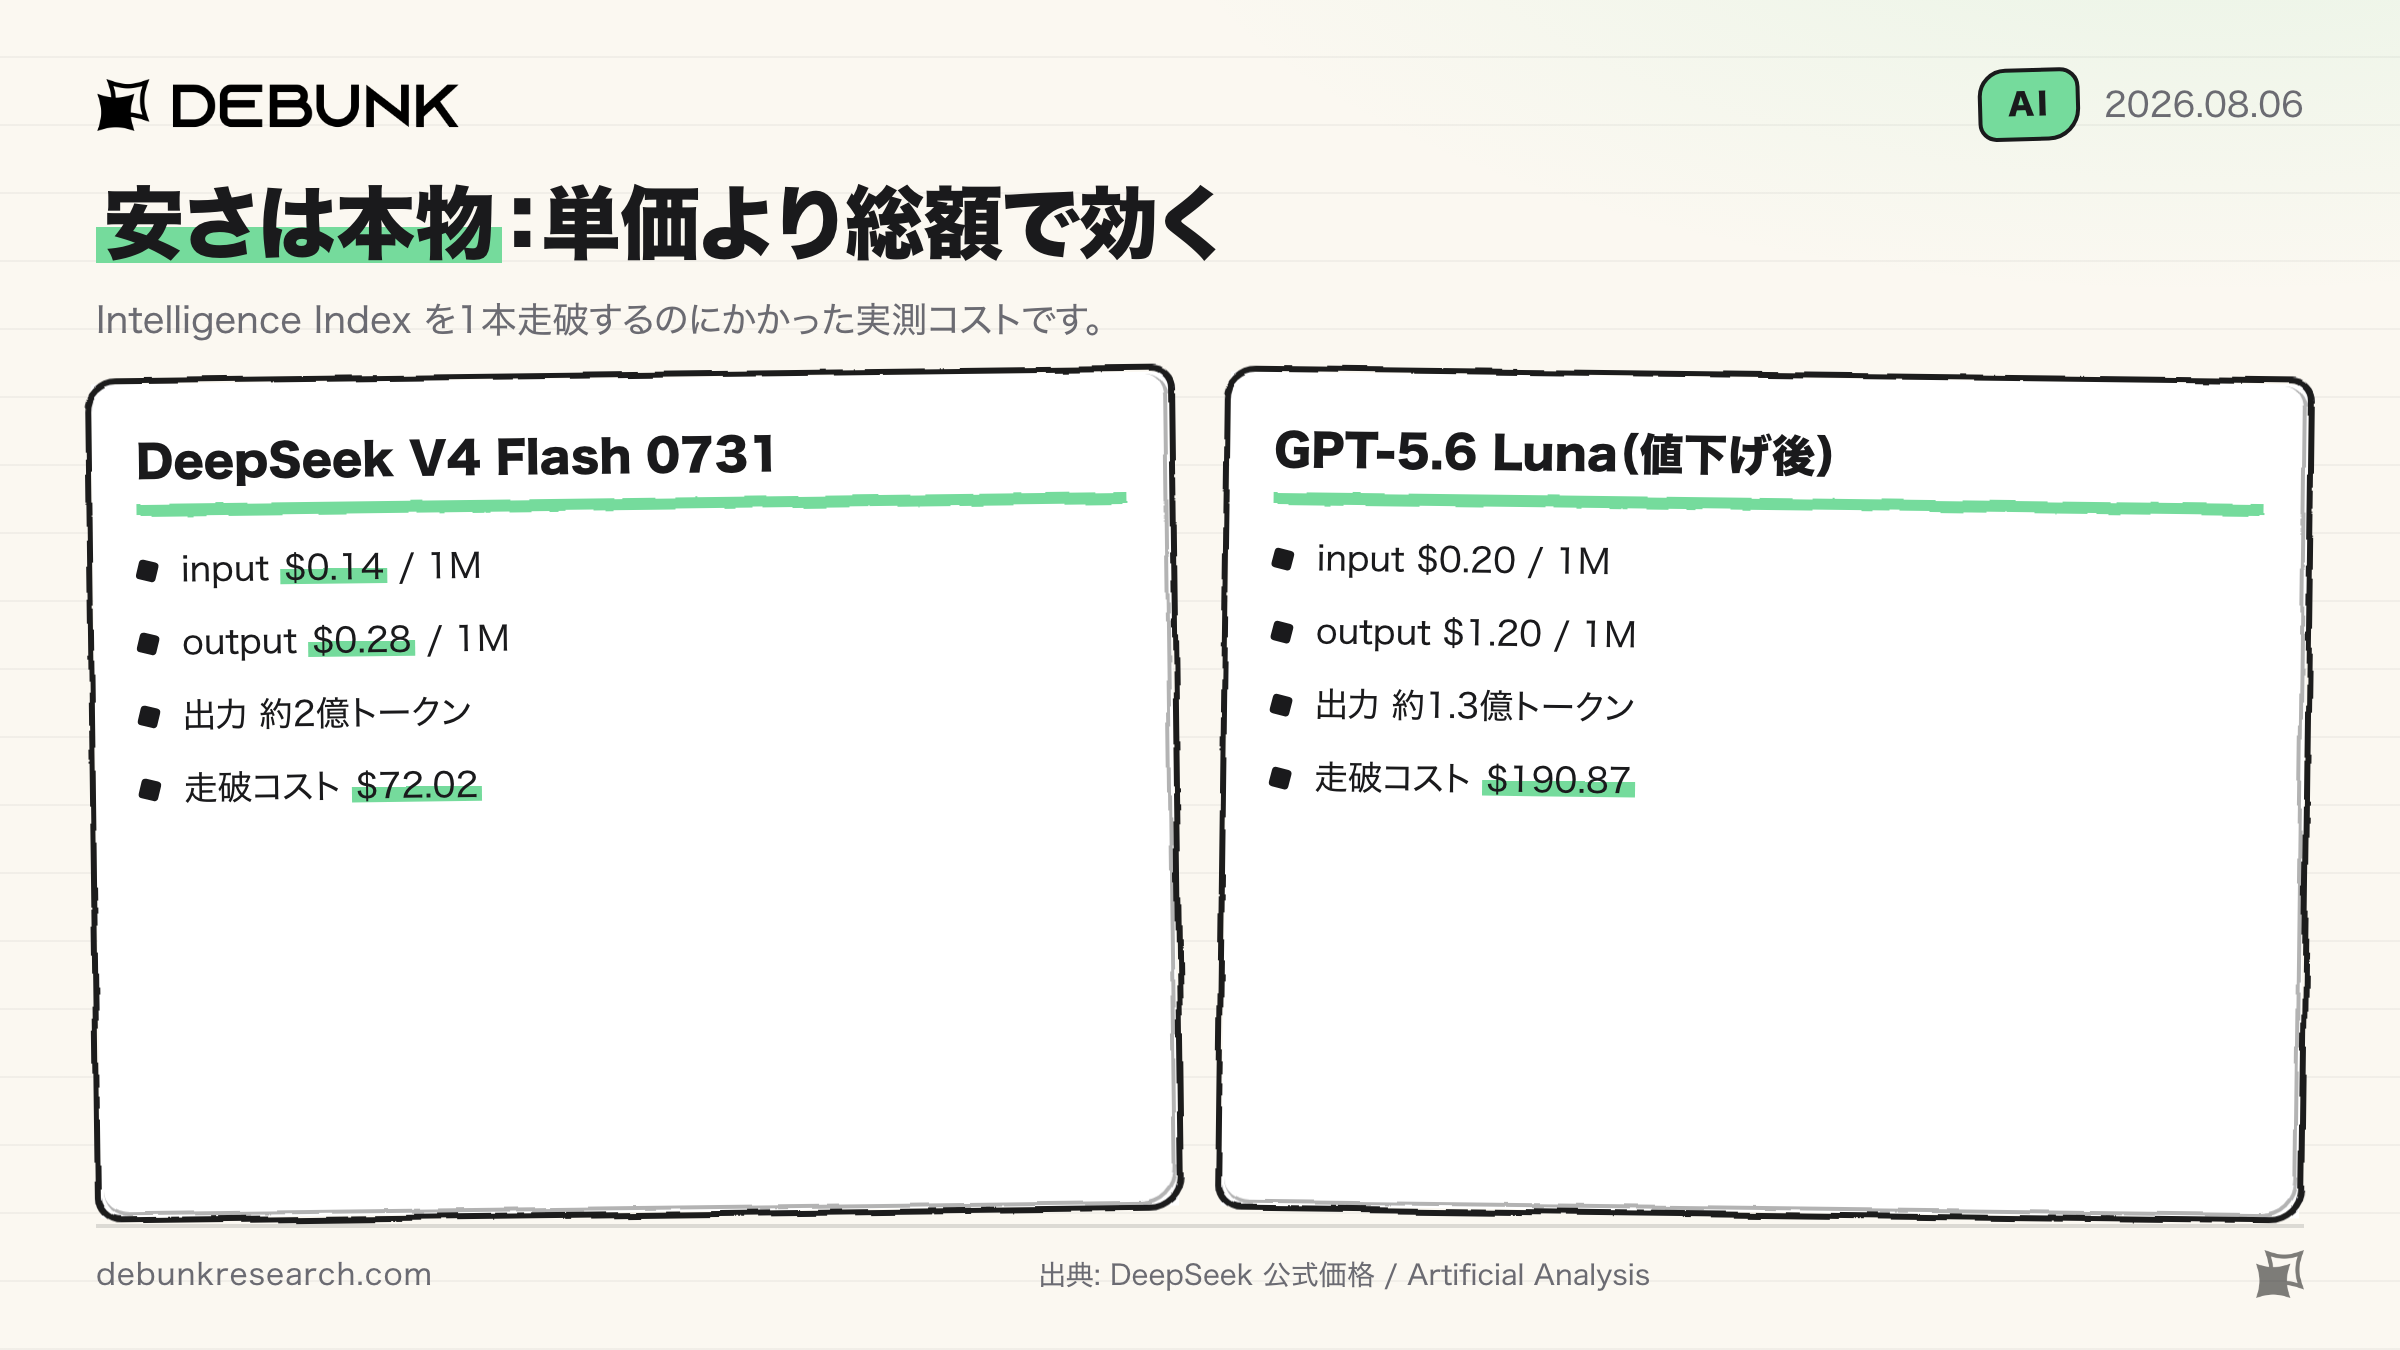
そして値下げ後の Luna でも、まだ高い。AA が Intelligence Index を走破するのにかかった総額は Luna $190.87 に対して DeepSeek $72.02 でした。AAはこれを「Pareto frontier に乗った」と表現し、Simon Willison も「現時点では最良の value-per-intelligence モデルかもしれない」と書いています。
2025年1月のR1ショックが第1サイクルなら、これが第2サイクル。違うのは、今回は米国側が先に価格で動いていたことです。
オープンウェイトの潮流|「禁止ではない」とAnthropicが書いた
このタイミングで目立ったのが、7月27日に Anthropic(Dario Amodei)が出したオープンウェイトについての立場表明です。
Anthropic has never advocated for a ban on open-weights models.
Open-weights models that don't have dangerous capabilities are a public good.
(危険な能力を持たないオープンウェイトモデルは公共財である)。懸念は2点——権威主義国家がより強力なモデルを持つこと、サイバー・生物攻撃への転用——に絞り、対策として①対中チップ輸出規制と密輸対策 ②「industrial-scale distillation operations(産業規模の蒸留)」の取り締まり ③十分に高性能なモデルへの義務的な安全性テスト、を挙げています。禁止ではなく条件付け、という整理ですね。
一方で、米国側のオープンウェイト供給は薄いままです。OpenAI の gpt-oss(120B / 20B、Apache 2.0)は2025年8月5日の公開で、2026年半ばでもこれが主要な配布物。Meta は Llama 4(2025年4月)が最新世代のままで Llama 5 は無く、代わりに出した Muse Spark はクローズドウェイトです(※Meta公式の確認は取れていません)。
Nathan Lambert は7月20日に、中国勢は蒸留による追随ではなく実力で並びつつあり、性能差は6〜9か月から3〜5か月に縮まったと書いています。
考察|「1点差」は何と比べた1点差なのか
「フロンティアに1点差」は事実として間違っていません。ただ検証しようとすると、4つの注釈が付きます。
注釈1|比較相手は、OpenAIの一番安いティア
GPT-5.6 は Sol / Terra / Luna の3層で、Luna は最も安く最も軽い最下位ティア。しかも7月30日の値下げで一段と安くなった直後でした。「51と1点差」は、フラッグシップに並んだ話ではありません。
注釈2|全体リーダーボードでは、50は上位15位圏外
AAのリーダーボードの上には Claude Opus 5 (max) 61、Claude Fable 5 60、GPT-5.6 Sol (max) 59、Kimi K3 (max) 57……と並び、DeepSeek V4 Flash 0731 (max) の50はトップと11点差。オープンウェイトに限っても Kimi K3 が上です。モデルページの「#3 of 101 in its class」はクラスの定義が非公開なので、絶対順位としては読めません。
注釈3|1点は、AA自身が示す誤差幅と同じオーダー
AAの方法論ページには「95% confidence interval of less than ±1%, based on experiments with over 10 repeats」——10回以上の反復にもとづき95%信頼区間は±1%未満と推定——とあります。指数ポイントか相対%かは原文から読み取れないため「誤差範囲だから同等」とは言えませんが、1点差はAA自身が示す不確実性と同じオーダーです。
注釈4|そもそも指標が6月に作り直されている
Intelligence Index は2026年6月15日に v4.1 へ再構成されました。ベンチの差し替え(Terminal-Bench Hard→2.1、τ²-Telecom→τ³-Banking、GDPval-AA→v2)、IFBench の削除、加重の見直し。実際、4月のAA記事では V4 Flash (max) 47 だったものが、7月の記事では 40 です。改訂が原因とは断定できませんが、バージョンを跨いだ点数比較は成立しません。「10点ジャンプ」も v4.1 基準の話で、しかも伸びの多くは34%を占めるエージェント枠から来ています。その主役 GDPval-AA v2 の採点は人手ではなく、複数のフロンティアLLMによる審査員パネルです。
「ハルシネーション12ポイント改善」の絶対水準
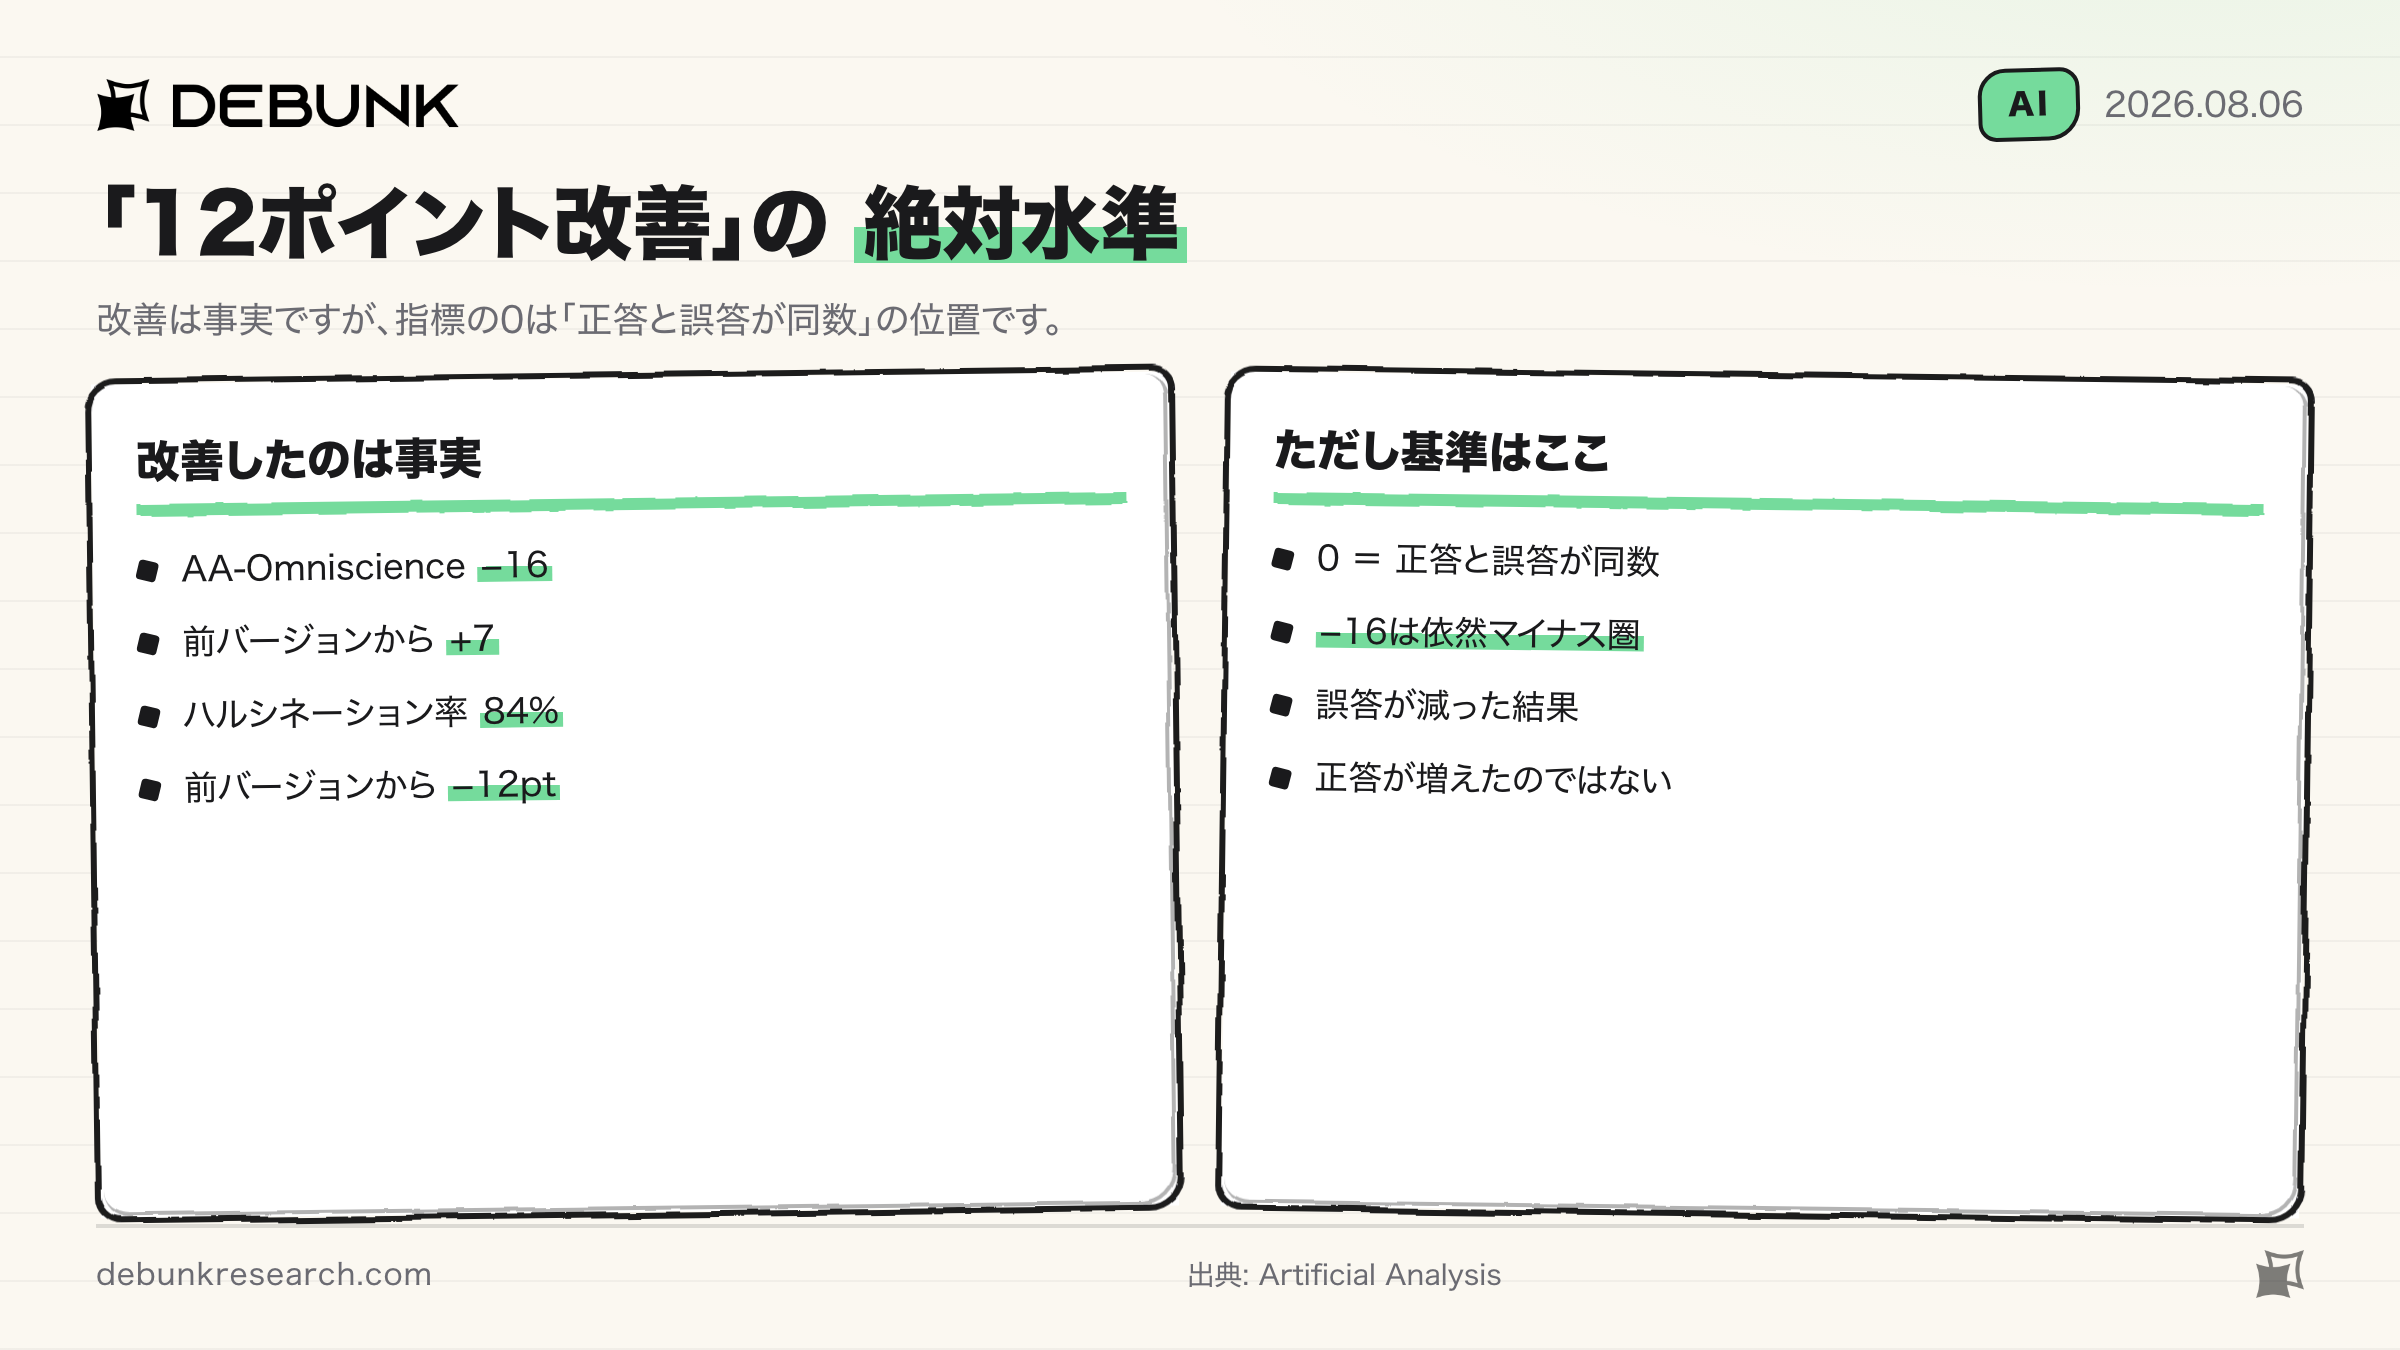
AA-Omniscience Index は −16で7ポイント改善。AA自身が「正答が増えたのではなく誤答が減った結果」と書いています。ただし指標は −100〜+100 で0が「正答と誤答が同数」の位置。−16 は依然マイナス圏で、ハルシネーション率も84%(正答できなかったケースのうち棄権せず誤答した割合)と高いままです。
それでも、6割安は本物です
単価だけなら input は −30%、output は −77%、AAのブレンド価格で −65%。ここまでなら「6割安」には届きません。しかもDeepSeek のほうが出力トークンが多い(約2億に対し Luna は1.3億。「トークン12%減」は前バージョン比の効率改善で、Luna 比でもハルシネーションの12ポイントとも別の数字です)。多く喋っているのに、Index 走破の総額は $72.02 対 $190.87 で62.3%安。同じタスク集合を実際に走らせた実測値です。
ただし、検証できない部分が3つ
- 評価ハーネスが非公開: 自己申告ベンチ(Terminal Bench 2.1 で82.7 など)は未公開の「DeepSeek Harness」で測られています。ランナーはコンテキスト圧縮・リトライ・完了判定を握るのでスコアに直接効き、第三者が再現できません。しかも比較列の Opus-4.8 に全項目で及ばず、その Opus-4.8 も1週間前の Claude Opus 5 登場で1世代前です
- 安全性評価が公式に無い: モデルカードにもAPIドキュメントにも該当セクションが見当たりません。第三者評価はありますが、対象はすべて V4-Pro であって Flash 0731 ではありません(FAR.AI は低スキル攻撃者の突破率98–100%、Neo Research はミスアラインメント事例の35%で意図的な有害行動と報告)。Flash 0731 の評価は見つからず、危険とも安全とも言えません
- 学習リソースの天井: 2026年5月20日の非公開投資家会合での梁文鋒の発言がリークとして報じられました(公式の確認も否認もありません)。学習には Huawei 950チップが20万基必要だが供給は1.6万基、「基本的に解決不能」で最低3年続く、という内容です
個人的な見解
このリークが事実なら、Anthropic の言う対中チップ規制の効き目を中国側の当事者が裏付けたことになります。今回が新規の事前学習ではなく事後学習のやり直しだったことも符合しますね。因果は断定できませんが、覚えておく価値のある並びです。
実務では、自前ホスティングが「アクティブ13B」の語感ほど楽ではありません。13Bしか動かなくても284B分の重みは保持が要るので、128GBのユニファイドメモリが実質的な最低ラインです(コミュニティの量子化実測ベース)。
見どころは2つ。AAが次に指標を改訂したときスコアがどう動くか。そして Flash 0731 を対象にした第三者の安全性評価が出てくるかどうか。要は、安さは今日から使えるが、1点差は文脈次第ということです。