目次
おはようございます。
今日は「Simile」をリサーチしました。
TL;DR
- Simileは実在の人物へのインタビューから「合成ユーザー」を作る米国スタートアップ。2026年7月30日、Greenoaks と Index Ventures の共同リードで $200M超の Series B をポストマネー $2B で調達しました($100MのSeries Aのわずか5か月後)
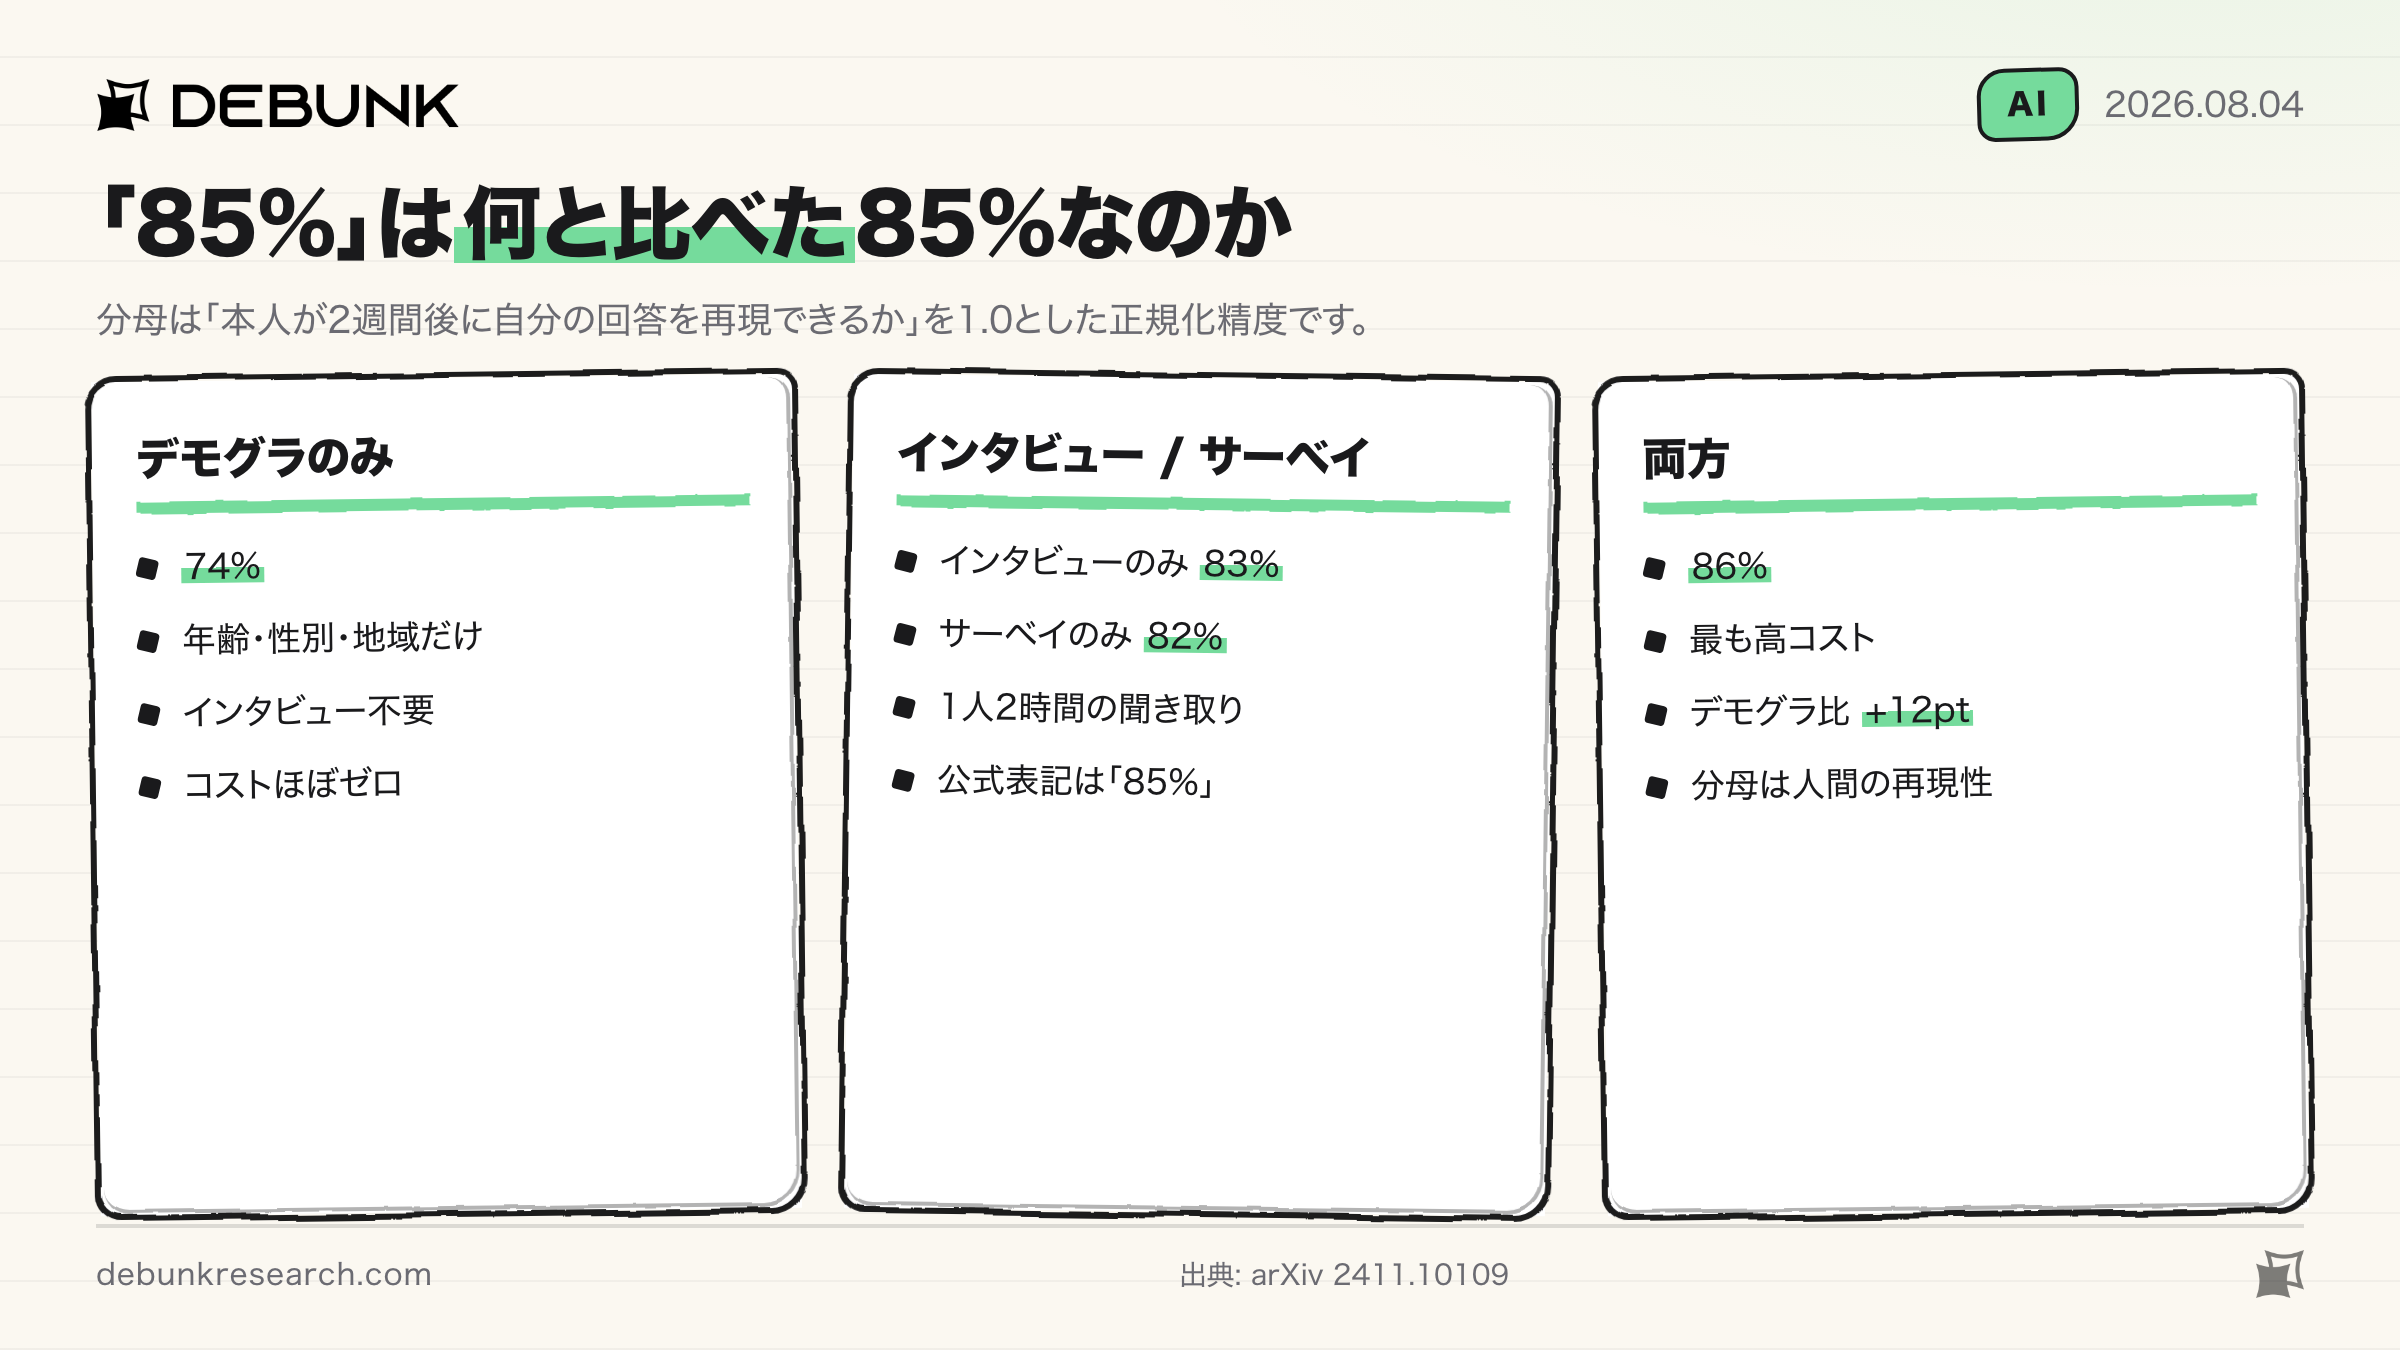
- 評価の根拠になっている「人間を85%の精度で予測できる」には注釈が要ります。現行論文の値は83% / 82% / 86%で、しかもデモグラフィック情報だけのエージェントが既に74%。分母は「本人が2週間後に自分の回答を再現できるか」です
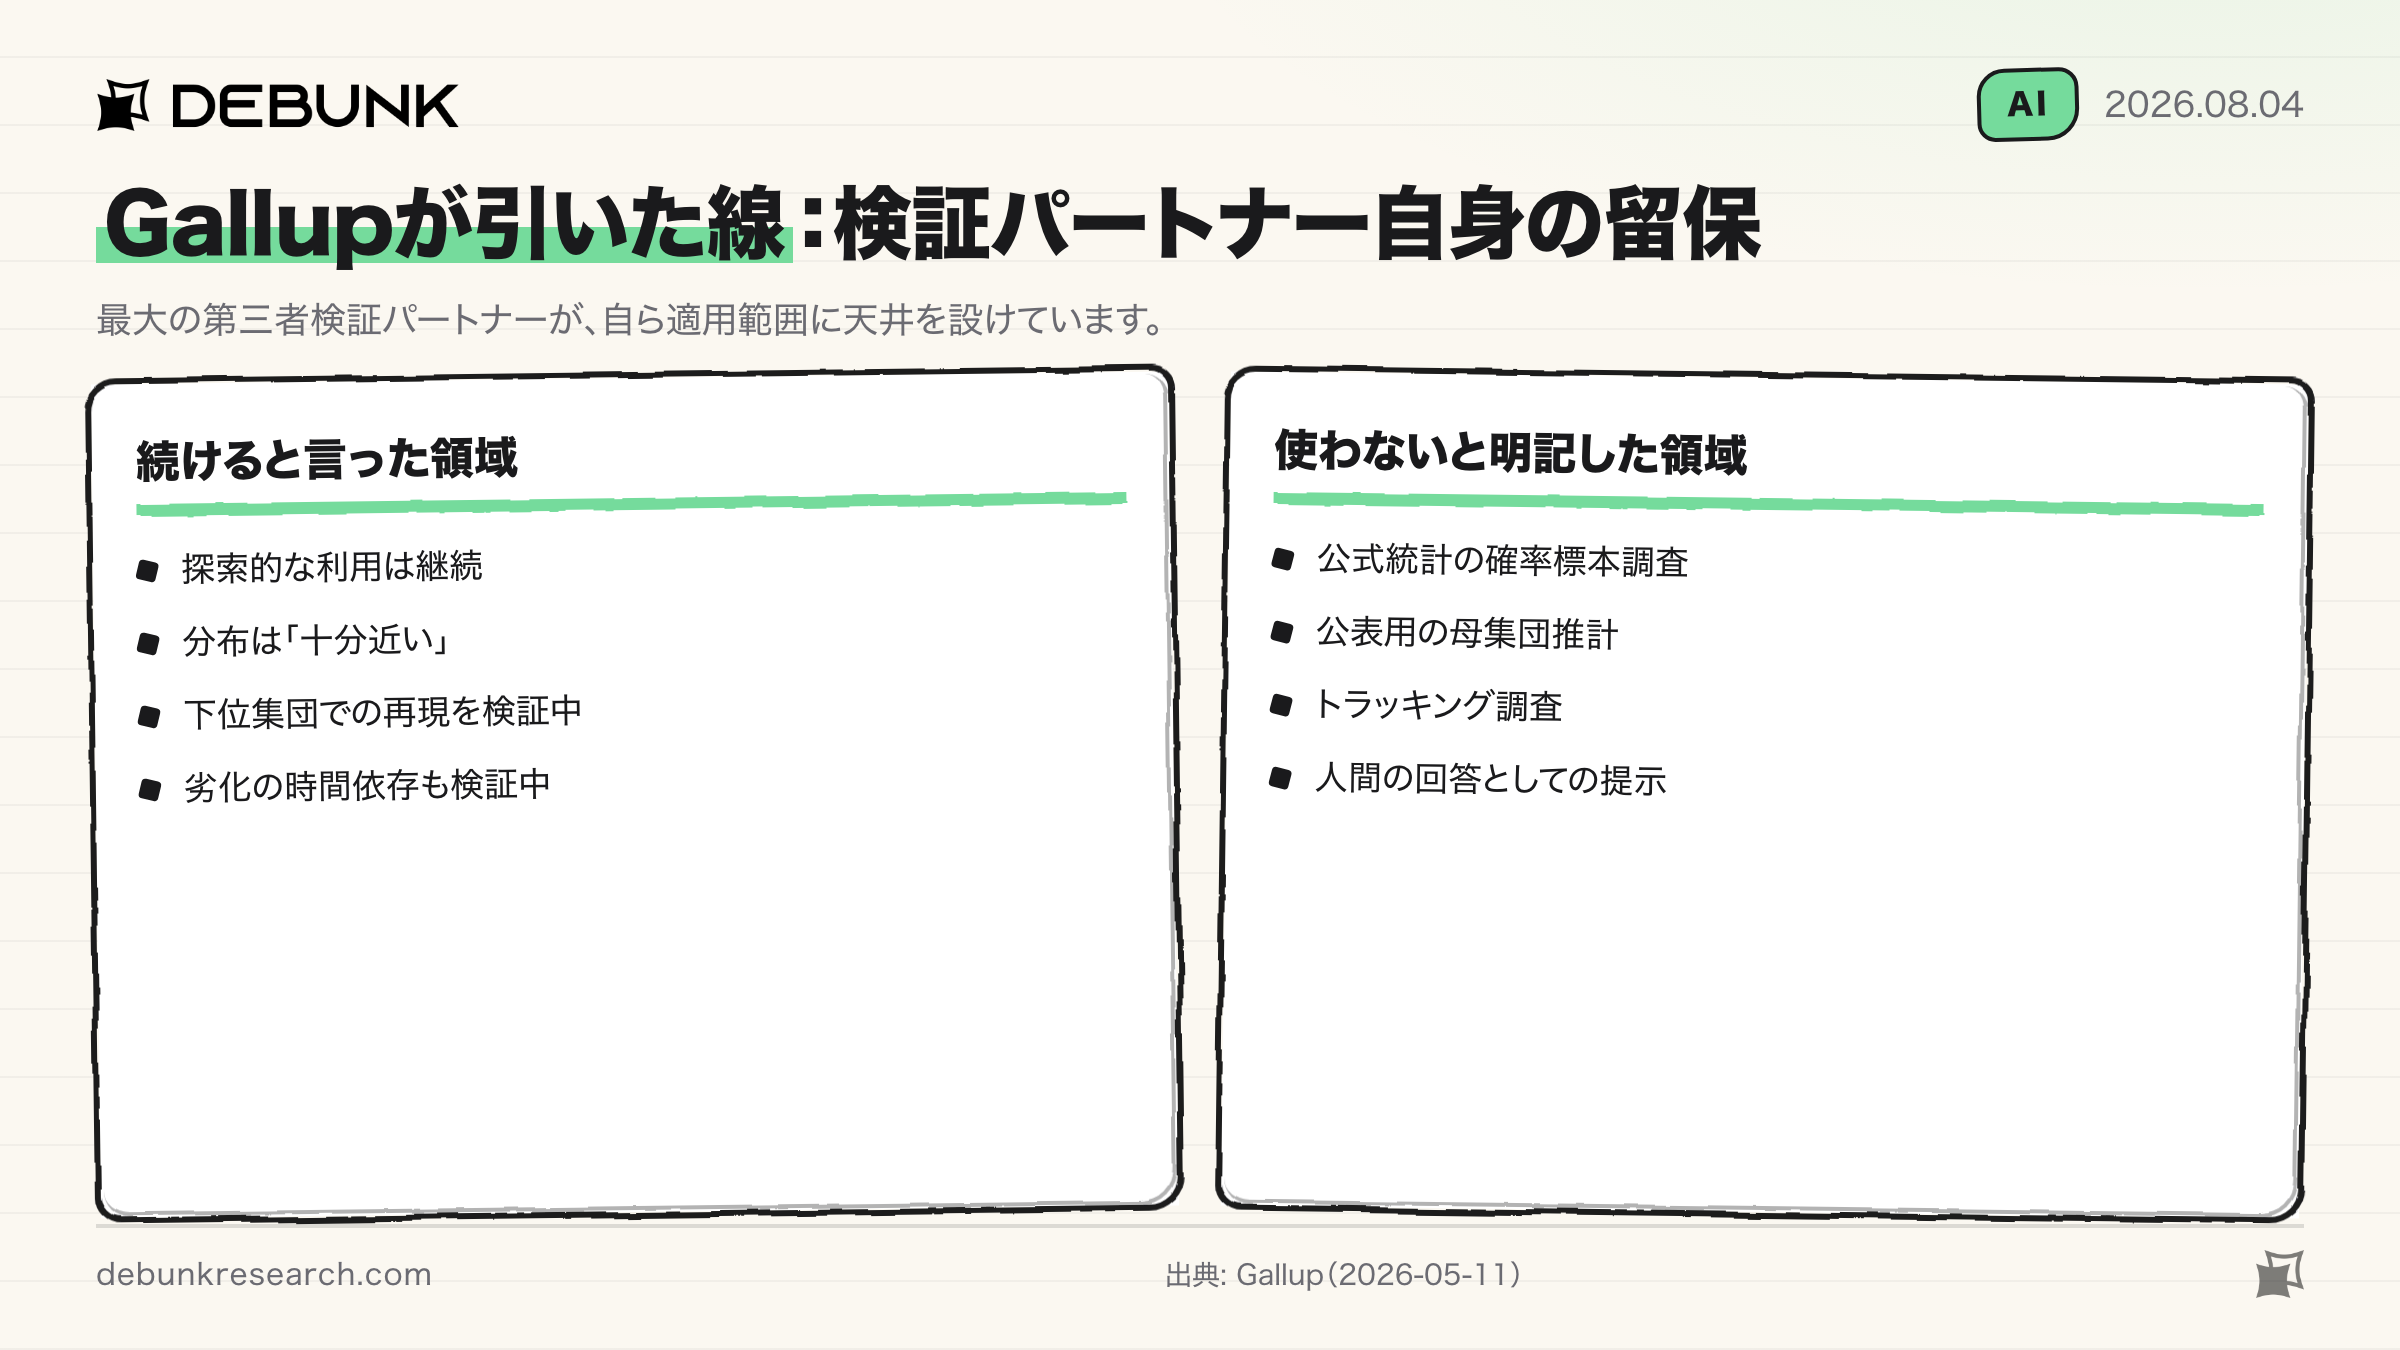
- 最大の第三者検証パートナーである Gallup 自身が「公表用の母集団推計には使わない」と適用範囲に天井を設けています。使うなら人間調査の代替ではなく、その手前のスクリーニングとして
概要|Simileとは?
Simile(シミーリー)は、スタンフォード大学の生成エージェント(generative agents)研究から生まれた米国のスタートアップです。自称は「The Simulation Company」。公式トップに掲げるミッションは「Our mission is to simulate all eight billion people in the world, accurately.」——世界の80億人を、正確にシミュレートする、というものです。
2026年7月30日、Greenoaks と Index Ventures の共同リードで$200M超のSeries Bをポストマネー$2Bで調達しました。$100MのSeries A(Indexリード)でステルスを解除したのが同年2月12日ですから、わずか5か月での再調達です。
作っているのは汎用LLMではなく、人間行動のファウンデーションモデル(foundation model)という位置づけのものです。
解決する課題
- 従来の市場調査は、1回のコンセプトテストで5〜10案しか試せない
- 慢性疾患の患者のような、既存パネルで捕まえにくい層の声が取りにくい
- 実際の顧客の前で失敗すると、信頼とコストをそのまま失う
CVS Health の Srikant Narasimhan(VP Enterprise Customer Experience & Insights)の言い方が、この課題を一番よく表しています。
With Simile, we don't need to fail fast in front of customers, we can fail safely in a controlled environment.
(Simileがあれば、顧客の前で素早く失敗する必要はない。管理された環境で安全に失敗できる)
プロダクトの柱
1. 実在の人物から作る
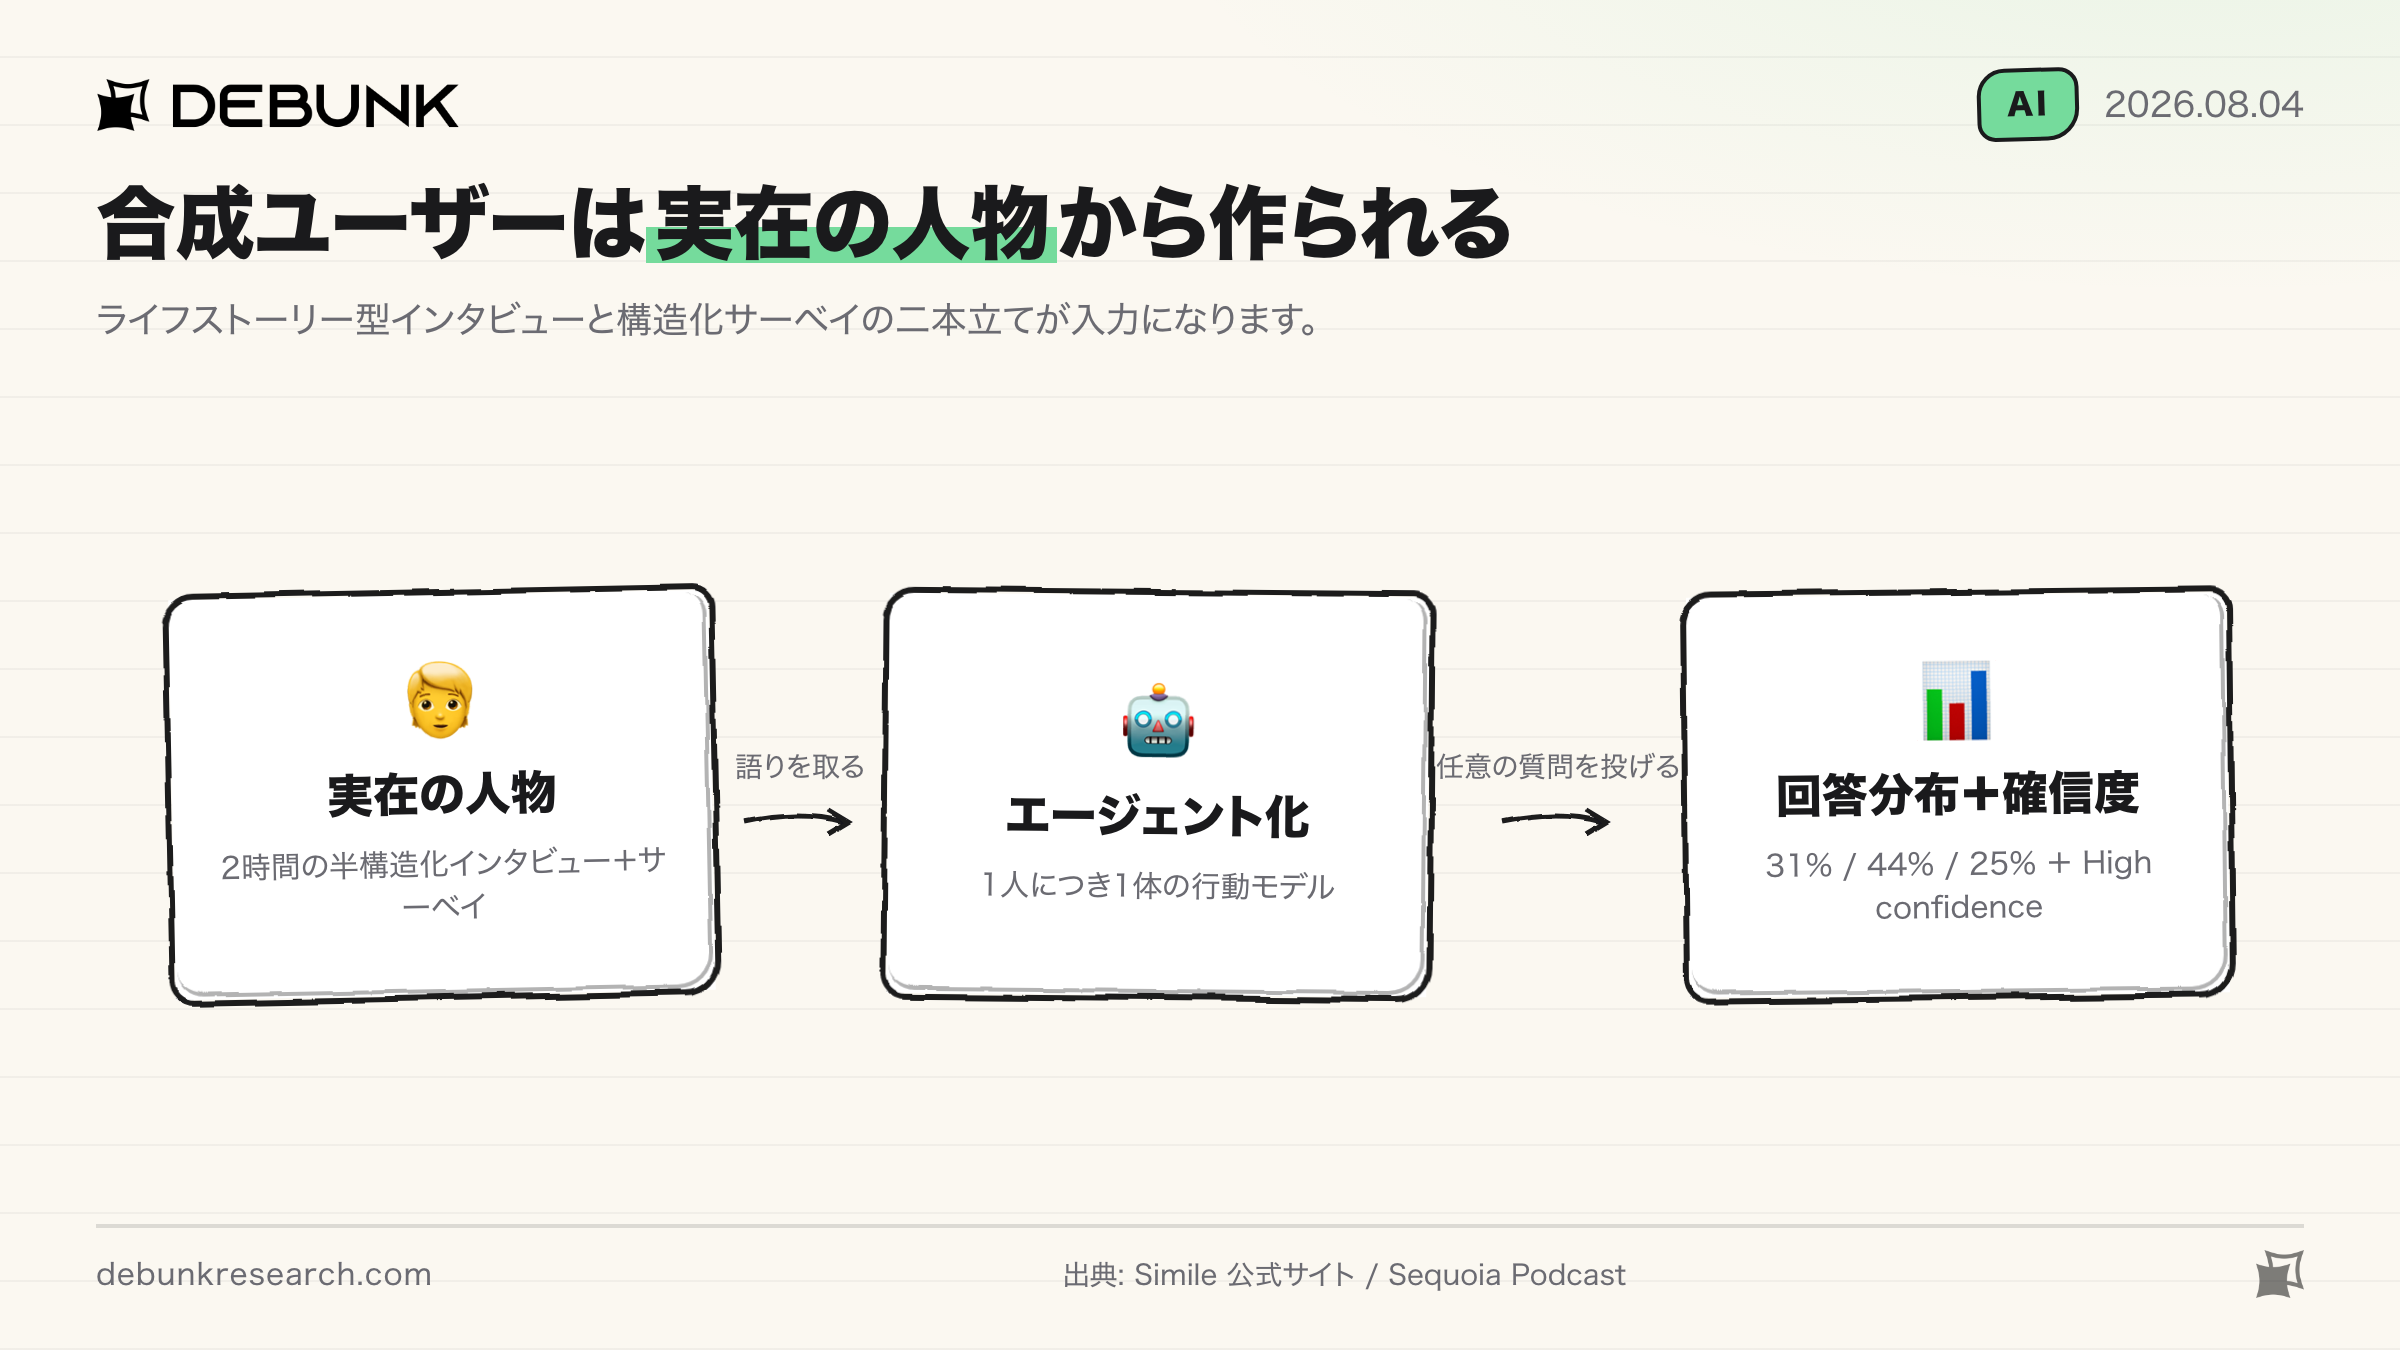
「Every Simile population starts with real people」と公式が書くとおり、入力は実在の人物です。ライフストーリー型のインタビュー(「tell me the story of your life」と尋ねる形式)で言語化されにくい情報を取り、事実確認的な項目は構造化サーベイで補う、という二本立てになっています。ここが、実在人物にひもづかないAIペルソナとの決定的な違いです。
2. 質問を投げると「分布」が返る
顧客はSaaSとして、関心のある集団に任意の質問を投げます。返ってくるのは1つの答えではなく回答の分布です。公式トップの実例では、「銀行の乗り換えに10分しかかからないなら誰が離脱するか」に対して、乗り換える31% / 満足だが乗り換えうる44% / 満足で残る25%、という形で返ります。
3. すべての結果に確信度ラベルが付く
差別化の核はここです。公式は「We validate against real humans weekly: over 7,000 evaluations」と述べ、その検証結果でAI確信度モデルを学習させ、すべての結果に予測精度のラベルを付けると説明しています。先ほどの銀行の例は High confidence、EV購入障壁の例は Moderately high confidence、という具合です。主指標は TVD(Total Variation Distance、全変動距離)で、創業者は「TVDが0.15未満なら意思決定に使える強い証拠だ」と述べています。ただしこの検証はすべて自己申告で、第三者監査はありません。
価格は公開されていない
公開価格は一切なく、CTAは "Request a demo" のみ。Fortune 100 中心の完全なエンタープライズ直販です。顧客として CVS Health、Wealthfront、Deloitte、Gallup の名前が出ています。Wealthfront の Andrew Crocco(Head of User Research)は「Simile expanded our qualitative research scope by 15X without losing depth.」——深さを失わずに定性調査の範囲を15倍にした——とコメントしています。
変遷|研究が会社になるまでの5年
創業者|論文が先、会社が後
Joon Sung Park(CEO・共同創業者)はスタンフォードのPhDで、指導教員だった Michael Bernstein と Percy Liang が、そのまま共同創業者に名を連ねています。ここでは中心となる Park と Liang の2名を取り上げます。Index Ventures は Park を「an oil painter turned entrepreneur」(油絵画家からの転身)と紹介しています。
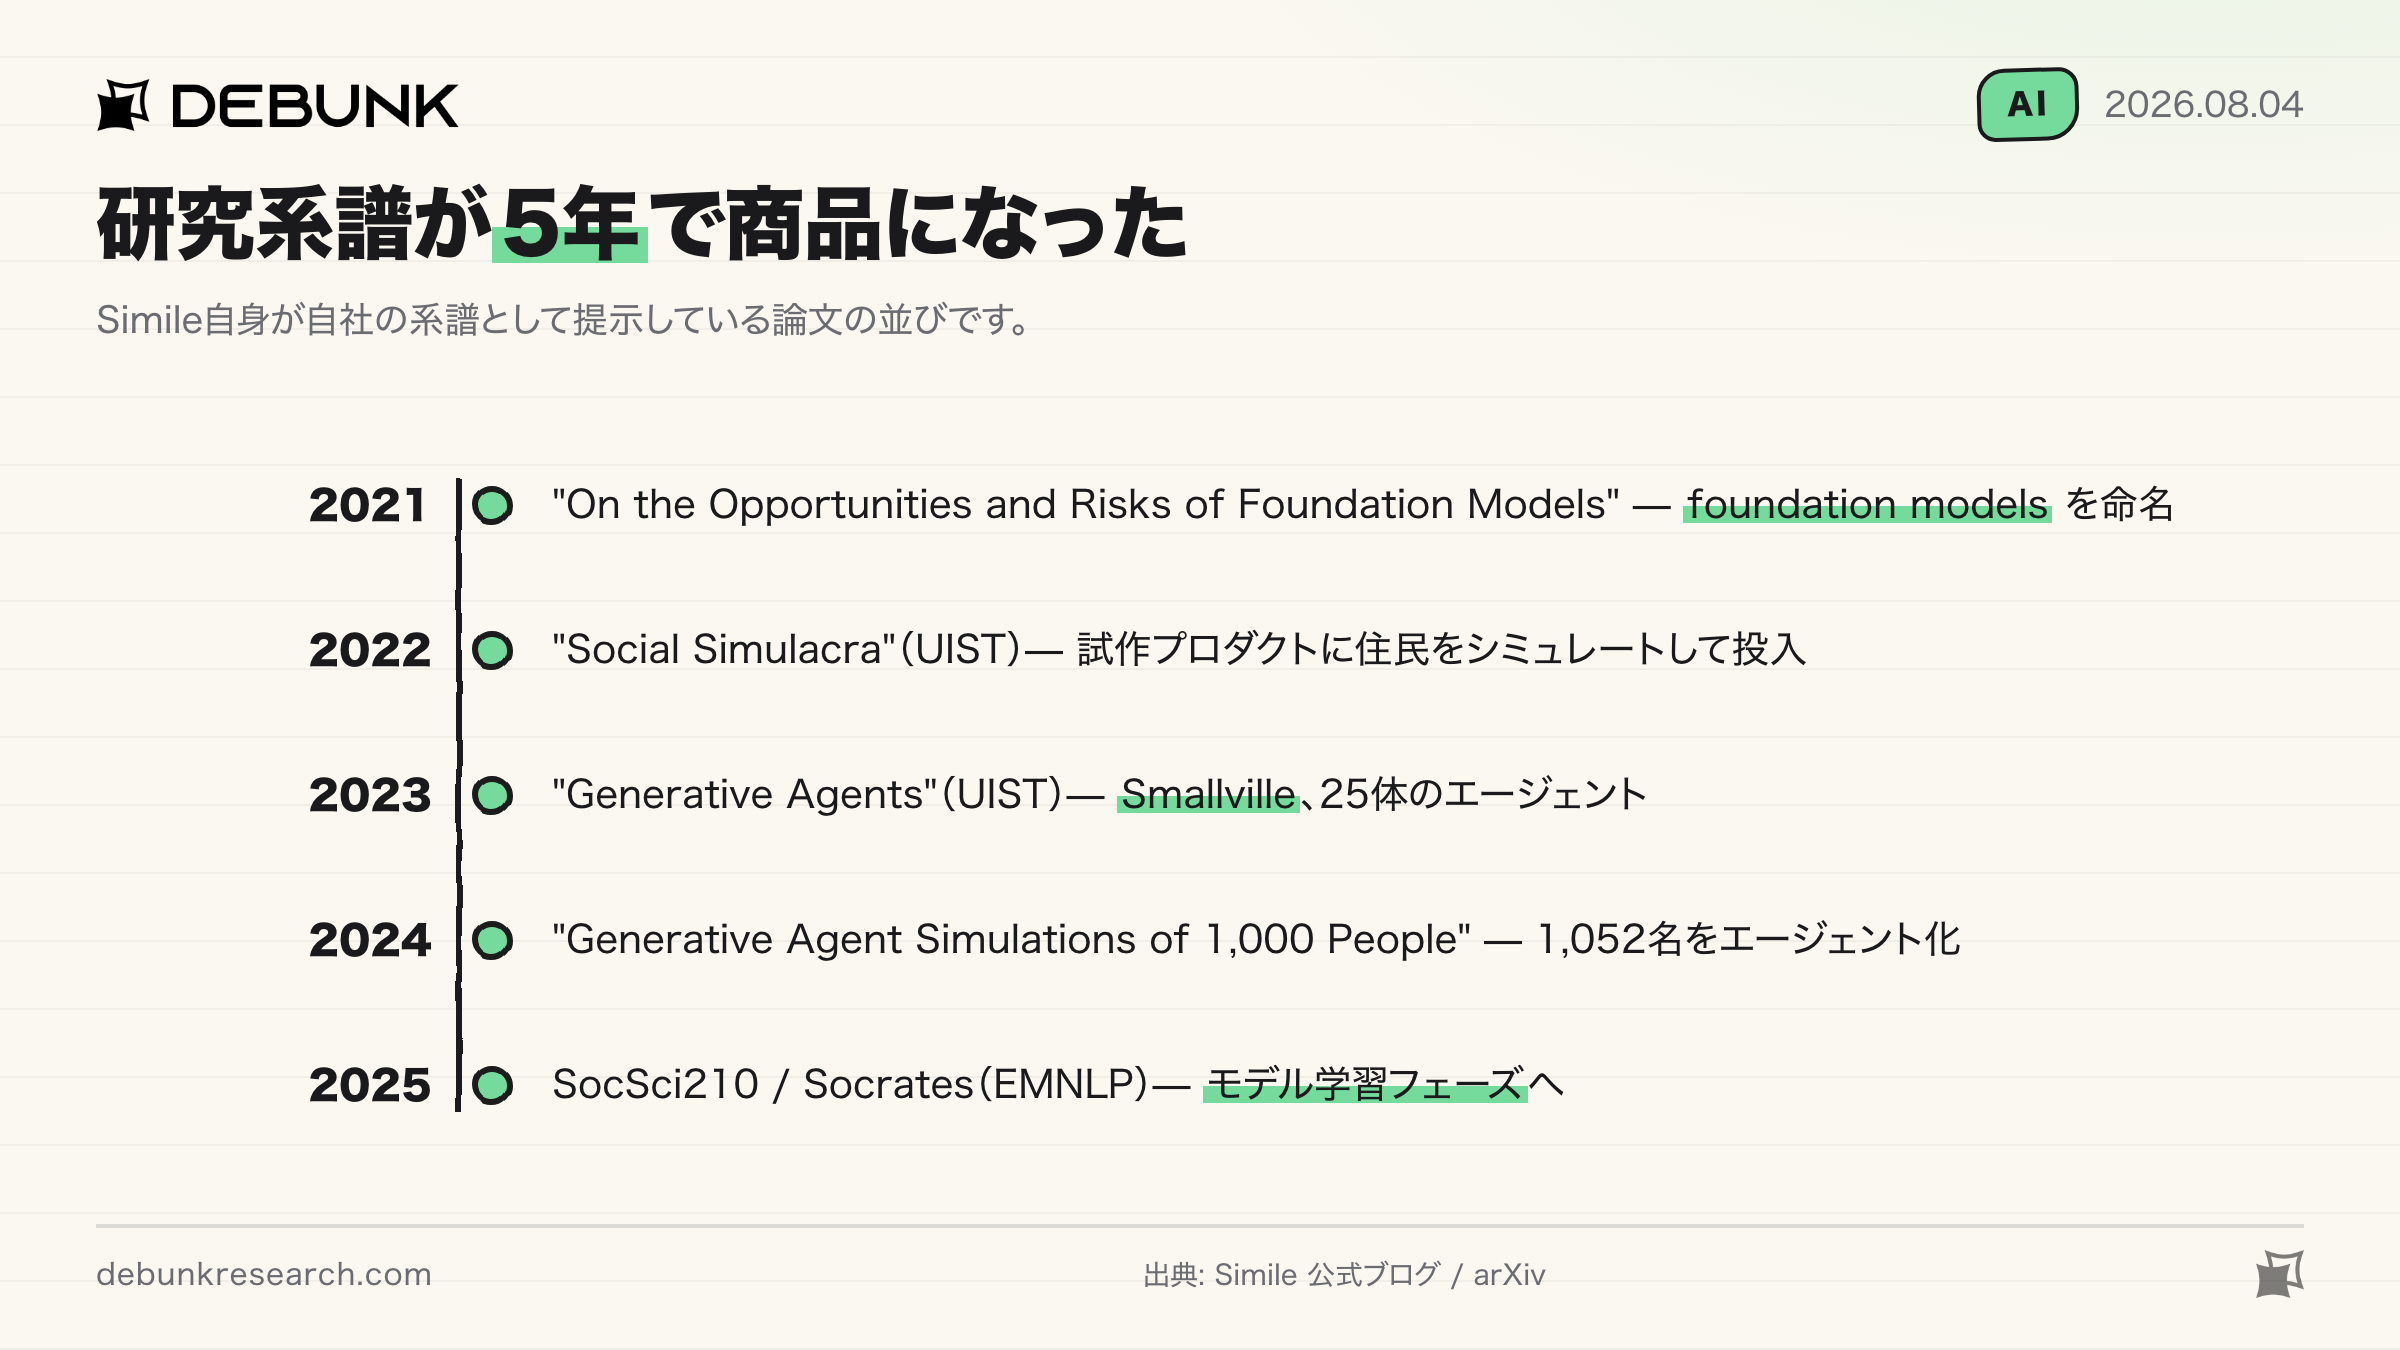
博士研究が、有名な「Smallville」です。仮想の町に25体のAIエージェントを住まわせ、人手の脚本なしに会話・日課・パーティーの開催まで生成させた実験で、論文 "Generative Agents: Interactive Simulacra of Human Behavior"(UIST 2023)として発表されました。
面白いのは順序です。起業は generative agents の約半年後。決め手になったのは、社会科学者と Fortune 500 からのインバウンドが来たことと、「シミュレーションが、本人が自分自身を再現するのと比べて85%の精度で行動を予測できる」と検証できたことでした。つまり「予測できる」ことを論文で先に証明してから、会社にしています。
Percy Liang(共同創業者)はスタンフォード CRFM を率い、2021年の "On the Opportunities and Risks of Foundation Models" で "foundation models" という語を作った人物です。彼はSimileブログで「予測の時代 → 推論の時代 → シミュレーションの時代」という3段階の世界観を示し、「リモートワークを許可したら組織の生産性と文化はどう変わるか」のような、多数の人間が時間をかけて相互作用した創発的な結果にしか答えのない問いはシミュレーションを要求する、と論じています。同時に技術課題も3つ挙げていて、高忠実度の人間・環境モデル(「今日の言語モデルは人間行動のニュアンスを捉えていない」と自ら認めています)、80億人を1年分回す効率、較正された確率推定による信頼、の3点です。
業界の変遷|研究系譜が5年で商品になった
Simile自身が自社の系譜として提示している論文の並びが、そのままこの分野の変遷になっています(→図版)。
要点は2024年の「1,000人論文」です。米国の多様な全国サンプル1,052名に2時間の半構造化インタビューを行ってエージェント化し、General Social Survey のホールドアウト項目で正解率を測りました。ここで使われた分母が独特で、本人が2週間後に自分の回答をどれだけ再現できるか(test-retest)を1.0とする正規化精度です。
結果はインタビューのみ83% / サーベイのみ82% / 両方86%。そしてデモグラフィック情報だけのエージェントが74%でした。この4つの数字の関係が、記事の後半で効いてきます。
2025年にはモデル学習フェーズに入ります。SocSci210 / Socrates は、210件のオープンソース社会科学実験から400,491名・290万件の回答を集めて構築したもので、最良モデル Socrates-Qwen-14B は人間の回答分布との整合がベース比+26%、GPT-4o を13%上回りました。
顧客が求めているのは「安い代替」ではありません。CVSのバイヤーが導入動機として語ったのは、5〜10コンセプトの検証ではなく「1,000のアイデア × 1,000のサブ集団」をテストしたい、というものでした。要は探索空間の桁を上げる話です。
資金調達|開示ベースで累計$300M超
- 2026年2月12日: Series A $100M(Index Venturesリード)=ステルス解除
- 2026年7月30日: Series B $200M超、ポストマネー$2B、Greenoaks と Index Ventures の共同リード。Hanabi、Bain Capital Ventures、A*、Factory、CVS Health Ventures、Definition が参加
累計は開示ベースで$300M超です(公式に累計の明記はなく、2ラウンドの算術)。自己申告のトラクションは、ローンチから5か月で売上5倍、Fortune 100 向けに数千万回規模のシミュレーション、50名超のグローバルチーム。
競合|同じ「合成ユーザー」でも層が違う
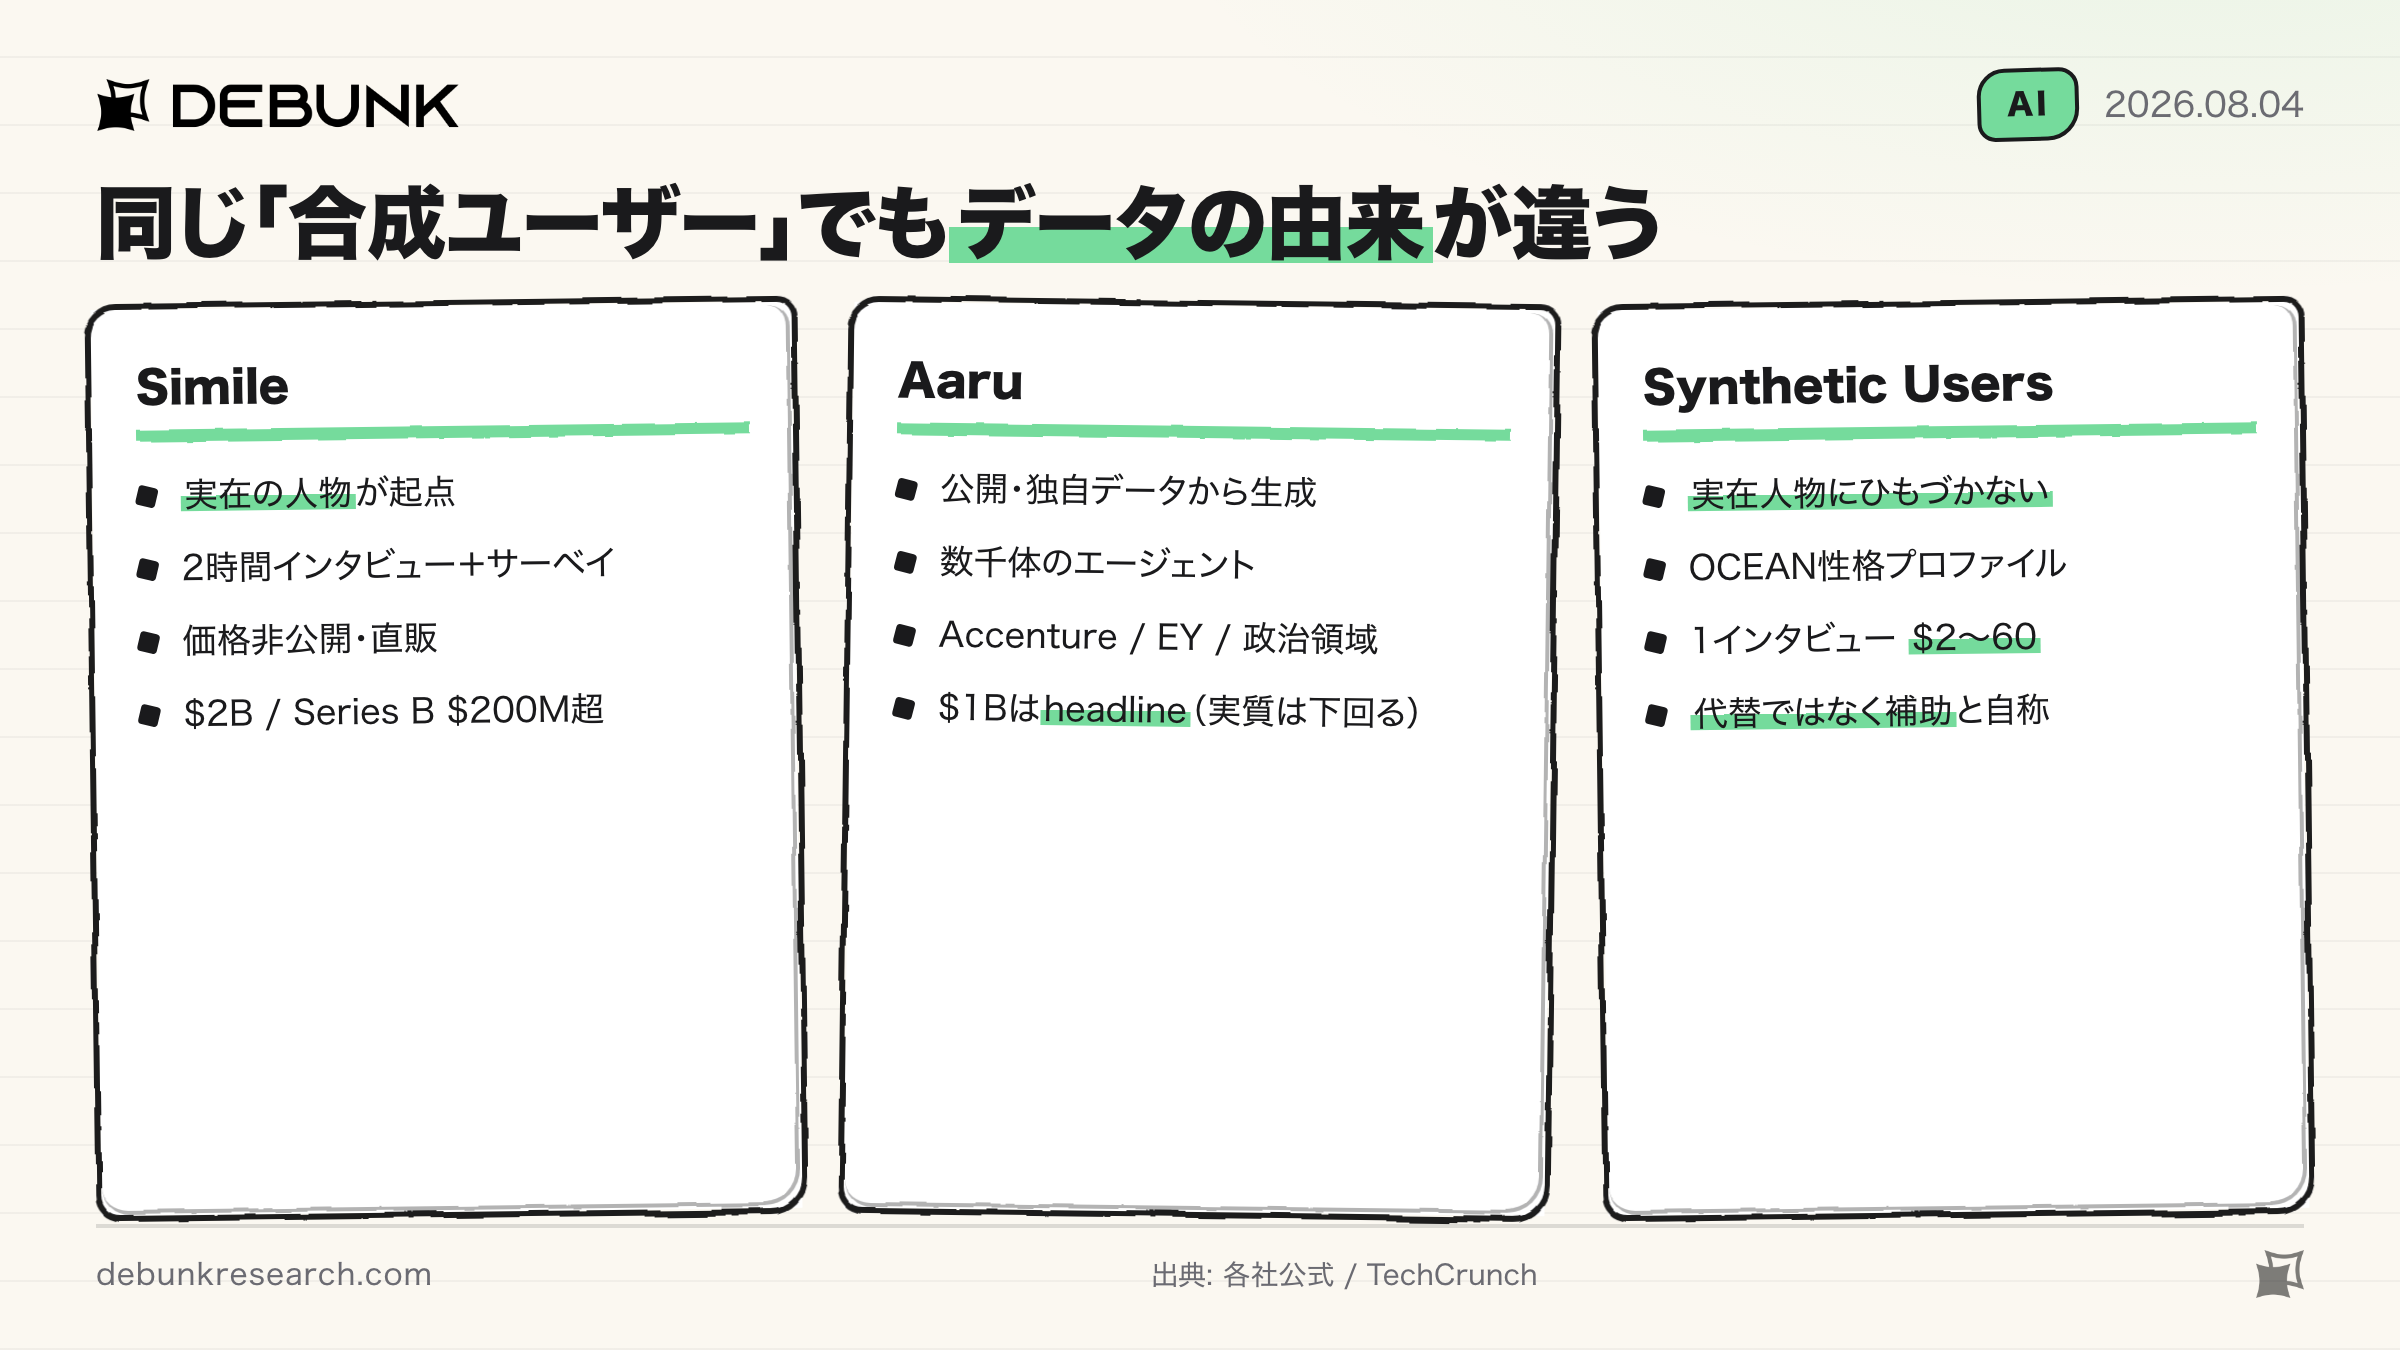
- Aaru: 2024年3月創業。公開・独自データから数千のAIエージェントを生成。2025年12月に Redpoint Ventures 主導で$50M超のSeries A。ただし$1Bは headline valuation で、より低い評価額で入った投資家もおり、ブレンド後は$1Bを下回るとTechCrunchが報じています
- Synthetic Users: 1インタビューあたり$2〜60(従来の調査会社は$100+)と価格を明示。OCEAN性格プロファイル上のAIペルソナで、実在人物にひもづいていない。自称は "a discovery co-pilot, not a replacement"
- Simile: 実在の人物へのインタビューが起点。価格非公開のエンタープライズ直販
考察|「85%」は何と比べた85%なのか
Simileの評価額$2Bを支えているのは、突き詰めると「人間を85%の精度で予測できる」という一文です。嘘ではありませんが、3つの注釈が付きます。
注釈1:現行論文に「85%」は単独で存在しない
公式サイトは2024年論文を「85% of human self-retest accuracy」と紹介していますが、arXivの現行版は83% / 82% / 86%です。85%は2024年11月の初出時の数値で、改訂後の論文に単独では出てきません。差は小さいものの、看板の数字が論文の更新に追従していない状態です。
注釈2:比較対象を変えると見え方が変わる
ここが一番大事です。同じ論文で、デモグラフィック情報だけのエージェントが既に74%に達しています。つまり「1人あたり2時間のインタビューを取る」という極めて高コストな工程が積み増している精度は、デモグラだけの場合に対して9〜12ポイントです。もちろん10ポイントで意思決定が変わることはありますが、Simileのコスト構造と価格の正当性は、この10ポイント前後が担っていることになります。
注釈3:分母が「人間の不安定さ」
正規化の基準(1.0)は、本人が2週間後に自分の回答を再現する一致度です。人間は2週間で意見も、質問の受け取り方も変わります。つまり「85%」は絶対的な正解率ではなく、人間本人の再現性を天井として、そこにどれだけ近いかの値。方法論としては妥当ですが、「85%当たる」と読むのは誤読です。
Gallupが引いた線
示唆的なのは、最大の第三者検証パートナーが自ら適用範囲に天井を設けていることです。Gallupは自社の確率パネルから約1,000名をエージェント化し、話題から離れたときの精度低下、下位集団での再現性、時間経過での予測の劣化を検証しています。
早期結果は「close enough ... to warrant continued exploration」(探索を続けるには十分近い)と肯定的です。一方で留保は非常に強く、確率標本調査は置き換えない/公表用の母集団推計やトラッキング調査には使わない/シミュレート回答を人間の回答として提示することは決してないと明記しています。
学術側からの2つの反論
- Sarstedt らのレビュー: 285件のシリコンサンプル vs 人間サンプルの比較で、一致24.9% / 乖離65.3% / 部分一致9.8%。人格特性や政治的選好のような安定した構成概念は再現できる一方、消費者行動の効果はしばしば既存知見と合わない。Simileの主戦場はまさにその領域です
- Jamie Cummins の研究: 生成にはモデル選択・パラメータ・プロンプト形式など恣意的な選択が多数あり、252構成を試すと何を見るかで結論が逆転する。既発表研究を66構成で再分析すると相関が r = .23〜.84 まで振れました。結論は、どれも擁護可能な設定選択の違いだけで忠実度に関する結論が実質的に変わりうる、というものです。
後者は確信度モデルへの反論でもあります。ラベル自体が設定選択の産物なら、信じる根拠が問われるからです。
個人的な見解
評価額$2Bは数字で検証できません。売上もARRも絶対額の開示がなく、あるのは「5か月で5倍」という倍率だけ。基準額が不明では評価に使えません。Aaruの$1Bが headline で実質は割れていたことも合わせると、この領域の評価額表示は引いて見るのが健全です。
構造的な引っかかりもあります。モデルは特定時点のインタビューにひもづきます。公式は「Agents consume media like the people they represent」と継続更新を謳いますが、その結果が本人の意見変化と一致する保証はなく、確かめるには本人に聞き直すしかない。検証コストが下がらない限り、シミュレーションのコストメリットは検証で相殺される——これは私の見立てですが、Gallupが検証項目に「時間経過での劣化」を入れているのも同じ理由でしょう。
とはいえ、否定的に読む必要もないはずです。CVSの「1,000のアイデア × 1,000のサブ集団」は、そもそも人間のパネルでは物理的にできません。人間調査の代替ではなくその手前のスクリーニングとして使うなら、74%と86%の差はそこまで重要ではなくなります。Gallupが引いた線——公表用の推計には使わない、探索には使う——が、たぶん現時点での正しい使い方です。
見どころは、次の資金調達までに絶対額のトラクションが出てくるかどうか。倍率でしか語れない期間が続くようなら、$2Bは研究の評判に付いた値段のままです。